Lançamento · Google DeepMind
EmbeddingGemma 2 leva busca multimodal para o dispositivo, mas português ainda pede teste
O modelo aberto transforma texto, código, imagens, áudio e vídeo em vetores comparáveis; os pesos já podem ser baixados, enquanto a integração empresarial continua futura.
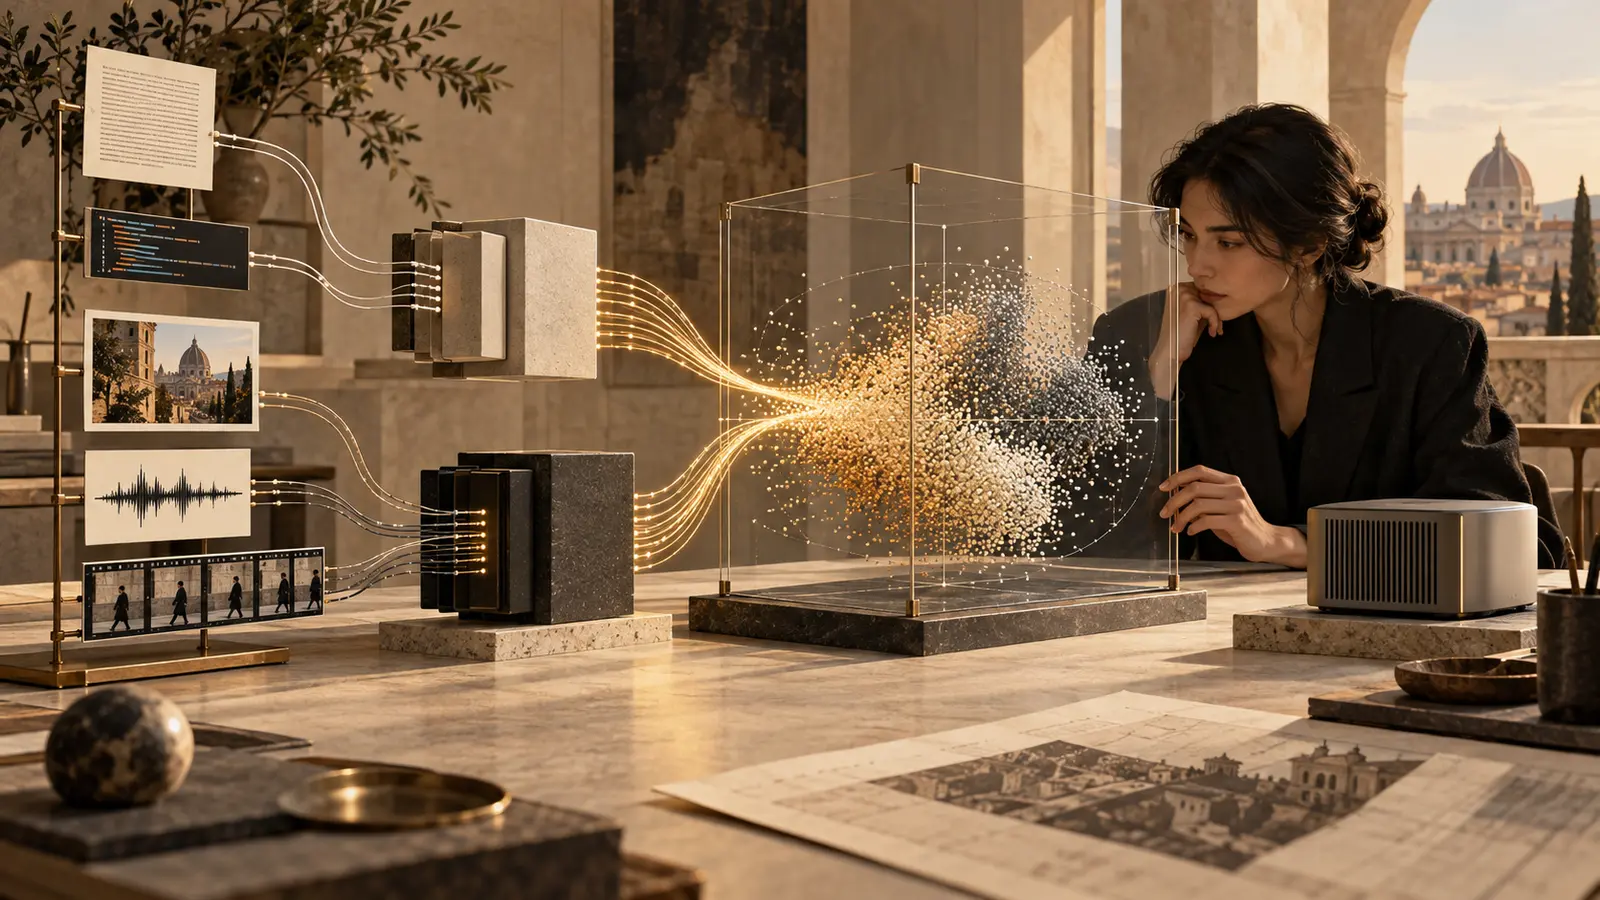
O Google lançou o EmbeddingGemma 2, um modelo aberto de 740 milhões de parâmetros para busca, classificação e recuperação multimodal no próprio dispositivo. Texto, código, imagem, vídeo e áudio entram no mesmo espaço vetorial, com encoders modulares e saídas que podem ser reduzidas para economizar armazenamento. Os pesos estão disponíveis sob Apache 2.0, mas os resultados publicados são do fornecedor e ainda não demonstram qualidade específica em português brasileiro.
- Acontecimento
- Publicação
- Última revisão
- Leitura
- 3 min
O que aconteceu
O Google publicou o EmbeddingGemma 2 em 6 de outubro. Os pesos estão disponíveis no Hugging Face e no Kaggle sob licença Apache 2.0, com suporte documentado para Transformers, SentenceTransformers, LiteRT, WebGPU, MLX, vLLM, llama.cpp e outras ferramentas.
O estágio é disponível como modelo aberto. A entrada no Model Garden da plataforma empresarial do Google foi anunciada como futura e não deve ser confundida com a disponibilidade atual dos pesos.
O que mudou
A geração anterior trabalhava com texto. A nova versão coloca texto, código, imagens, vídeo e áudio em um espaço vetorial comum de 768 dimensões, permitindo recuperar uma mídia a partir de outra, como encontrar um trecho de vídeo por uma consulta de voz.
A arquitetura combina um módulo de texto de 270 milhões de parâmetros com encoders opcionais de visão, com 170 milhões, e áudio, com 300 milhões. O contexto chega a 8.192 tokens e a saída pode ser truncada para 512, 256 ou 128 dimensões.
Por que importa
Acervos profissionais raramente são apenas textuais. Plantas, fotos de obra, vídeos de visita, memoriais, reuniões gravadas e referências visuais podem entrar na mesma camada de busca sem depender de um modelo generativo para cada consulta.
Rodar embeddings no dispositivo também pode reduzir exposição de conteúdo e latência. Isso não garante privacidade por si só: vetores, índices, arquivos originais, logs e aplicativos continuam exigindo controle de acesso, retenção e proteção.
Para quem importa
Equipes que mantêm bibliotecas de projetos, materiais, imagens, vídeos, gravações, pesquisa e documentos técnicos. Desenvolvedores de busca interna, RAG, classificação, recomendação e deduplicação também ganham uma opção aberta e modular.
Para escritórios menores, o interesse está em protótipos locais que não exigem uma API por consulta. A operação ainda demanda integração técnica, banco vetorial, processamento de mídia e uma interface de revisão.
Impacto prático
O Google relata 78,68 pontos no MTEB Code, contra 68,76 da versão anterior, além de liderança entre modelos multimodais com menos de um bilhão de parâmetros. Esses números vêm da avaliação do próprio fornecedor; a cobertura independente confirma o lançamento e a disponibilidade, mas não reproduz o desempenho.
Reduzir vetores economiza armazenamento, porém não é neutro. O model card mostra perda maior em tarefas multimodais na saída de 128 dimensões e a recomenda principalmente para texto. A documentação também recomenda atenção ao prefixo de tarefa e à precisão numérica.
O que testar
Monte um conjunto pequeno em português brasileiro com cinquenta itens: documentos, imagens, áudios e vídeos cujas relações sejam conhecidas. Escreva consultas reais da equipe e compare recuperação correta, falsos positivos, tempo, memória e tamanho do índice em 768, 512 e 256 dimensões.
Inclua termos técnicos, nomes de materiais, abreviações, fala espontânea e imagens parecidas. Compare o resultado com uma busca lexical e com um embedding já usado pelo escritório, registrando quando a modalidade ou o idioma altera o ranking.
O que observar
Acompanhe a chegada ao Model Garden, versões quantizadas, suporte estável nas bibliotecas, testes independentes e resultados por idioma. Observe também custo total de criar, atualizar e proteger índices multimodais grandes.
Verifique se futuros benchmarks incluem português brasileiro, documentos profissionais, imagens técnicas e consultas cruzadas entre modalidades, em vez de apenas médias globais.
O que ainda não sabemos
Não há benchmark independente amplo nem resultado separado para português brasileiro. O desempenho pode variar entre os mais de cem idiomas declarados, tipos de mídia, formatos, ruído e domínio profissional.
Também não há preço ou data da integração empresarial futura, nem demonstração pública de que o modelo supera alternativas maiores no acervo específico de um escritório.
Fontes
- EmbeddingGemma 2: an open, lightweight multimodal embedding modelGoogle · Blog oficial · publicada em 6 de outubro de 2026 · conferida em 12 de outubro de 2026
- EmbeddingGemma 2 model cardGoogle DeepMind · Documentação · publicada em 6 de outubro de 2026 · conferida em 12 de outubro de 2026
- EmbeddingGemma documentationGoogle AI for Developers · Documentação · conferida em 12 de outubro de 2026
- Google claims EmbeddingGemma 2 outperforms rival embedding models twice its sizeThe Decoder · Veículo especializado · publicada em 6 de outubro de 2026 · conferida em 12 de outubro de 2026