IA Lab by amano
Radar de IA

O que mudou em IA e o que realmente importa

Uma curadoria do IA Lab sobre mudanças que podem afetar criatividade, arquitetura, design, negócios, produtividade e empresas.

18 entradas encontradas

LançamentoShengShu Technology

Vidu Q4 combina referências, câmera e áudio em vídeos curtos, ainda como preview
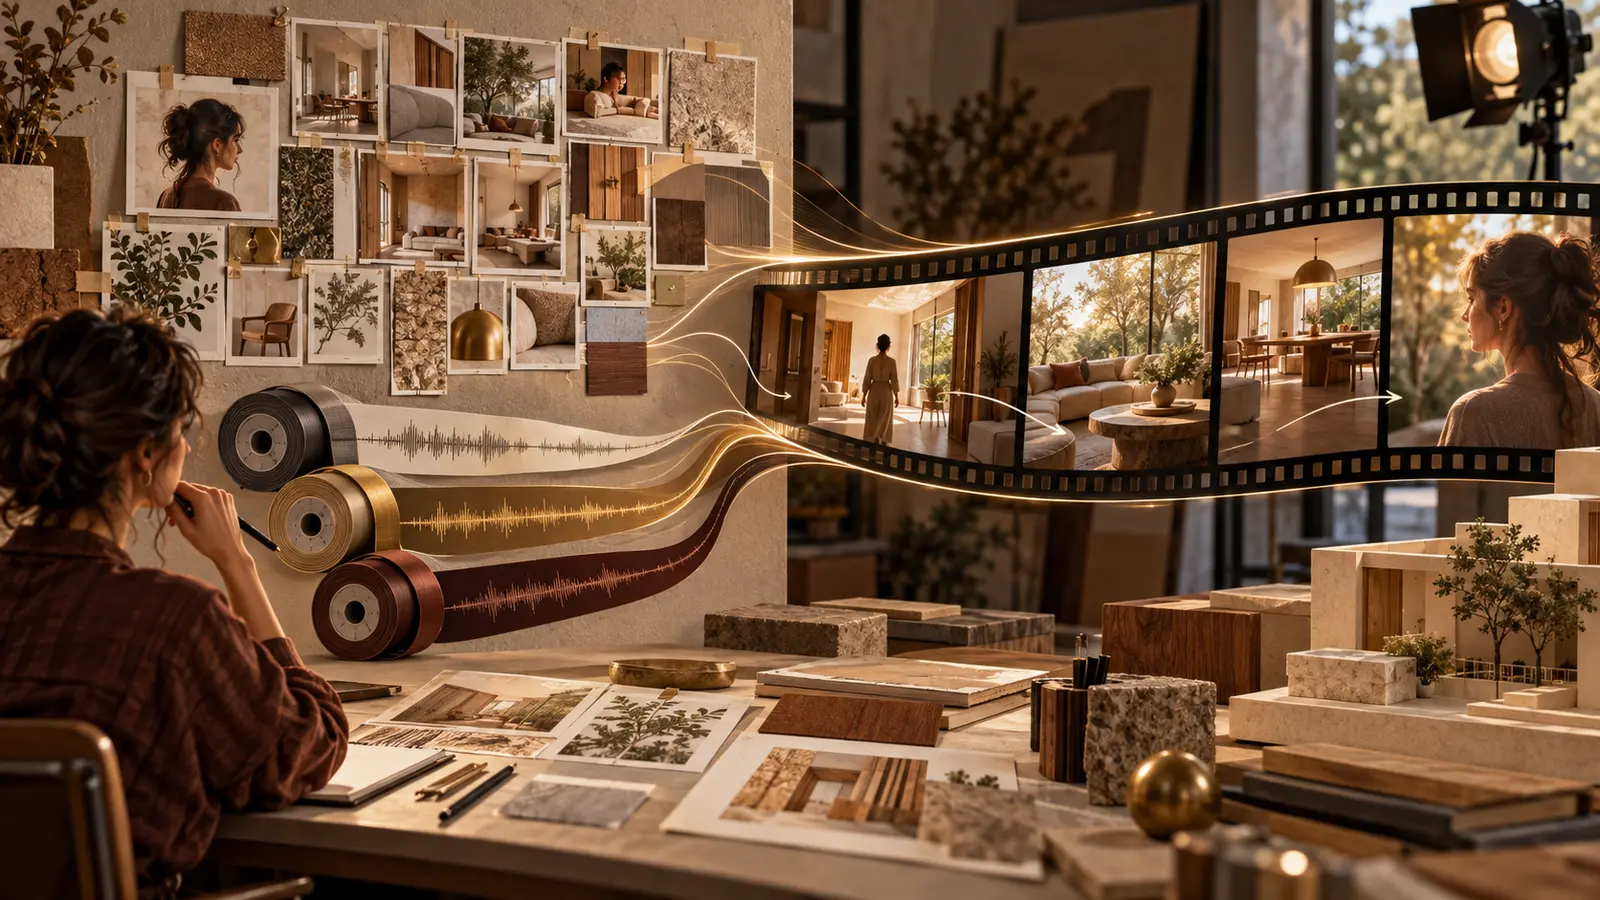
Referências de interiores, materiais e personagem se unem a três faixas de áudio e formam uma curta tira de filme, acompanhada por uma diretora diante de uma maquete arquitetônica.
Ilustração conceitual do fluxo por referências. Imagens e áudio orientam uma sequência curta com movimento de câmera; o resultado serve à narrativa visual, não ao modelo técnico do projeto.

O Vidu Q4 Preview está disponível no produto web e por API para transformar uma imagem inicial ou um conjunto de referências em clipes com áudio e troca automática de câmera. O modo por referência aceita até quinze imagens e três arquivos de áudio; a duração vai de três a dezesseis segundos e a resolução pode chegar a 4K. Em avaliação independente de image-to-video, o modelo ficou estatisticamente empatado com os líderes, mas o estágio continua preview e não há evidência de integração com CAD ou BIM.

Por que importa. A ferramenta aproxima continuidade visual, som e direção de câmera num único fluxo. Para equipes criativas, pode acelerar storyboards e apresentações, desde que duração, custo, direitos e consistência sejam testados antes de entrar numa entrega.
Ler análise

4 min de leitura

CriatividadeDesignArquiteturaProdutividadeVídeoÁudioImagemMultimodalidadeAPIs

LançamentoGoogle DeepMind

EmbeddingGemma 2 leva busca multimodal para o dispositivo, mas português ainda pede teste

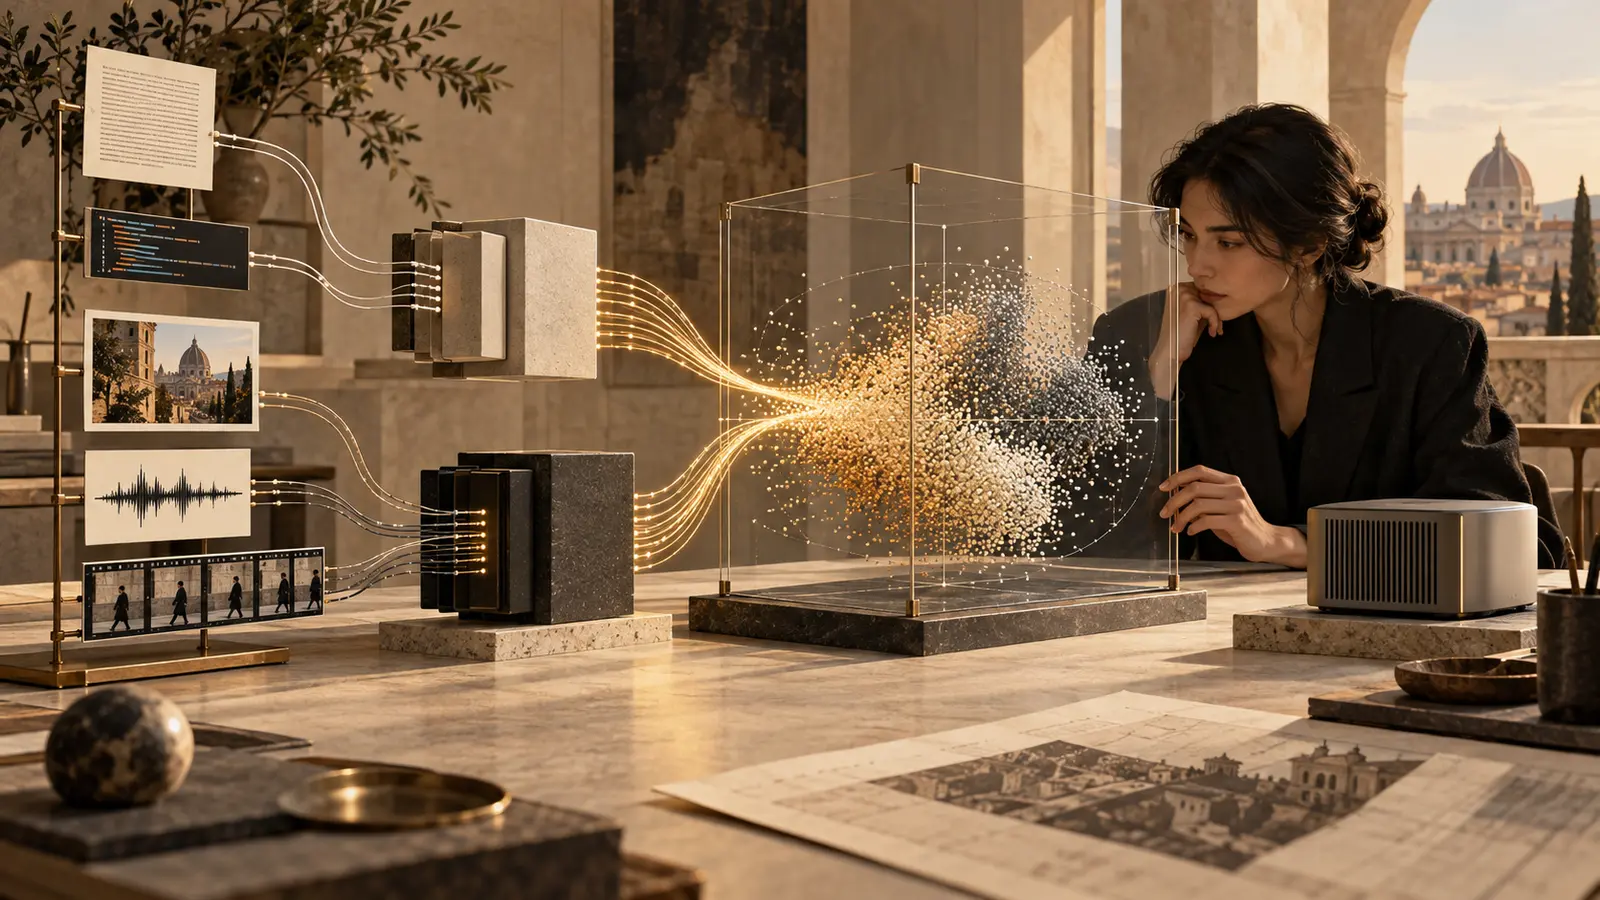
Uma mesa de arquivo recebe página, imagem, faixa de áudio e sequência de vídeo; cada mídia atravessa módulos físicos e chega a um mapa comum de pontos, revisado por uma pesquisadora.
Ilustração conceitual da busca multimodal local. Mídias diferentes viram representações comparáveis no mesmo mapa, enquanto a equipe testa idioma, precisão e custo de armazenamento antes de usar o resultado.

O Google lançou o EmbeddingGemma 2, um modelo aberto de 740 milhões de parâmetros para busca, classificação e recuperação multimodal no próprio dispositivo. Texto, código, imagem, vídeo e áudio entram no mesmo espaço vetorial, com encoders modulares e saídas que podem ser reduzidas para economizar armazenamento. Os pesos estão disponíveis sob Apache 2.0, mas os resultados publicados são do fornecedor e ainda não demonstram qualidade específica em português brasileiro.

Por que importa. Busca semântica local deixa de ficar limitada a texto. Escritórios podem indexar acervos de documentos, imagens, vídeos e áudios sem enviar cada consulta a uma API externa, mas a utilidade depende de testes com o próprio repertório, idioma e hardware.

Ler análise

3 min de leitura

ConhecimentoProdutividadeEmpresasMultimodalidadePesquisaLLMsPrivacidade

LançamentoMecAgent

MecAgent V2 leva especificações até CAD nativo, mas ainda exige revisão de engenharia

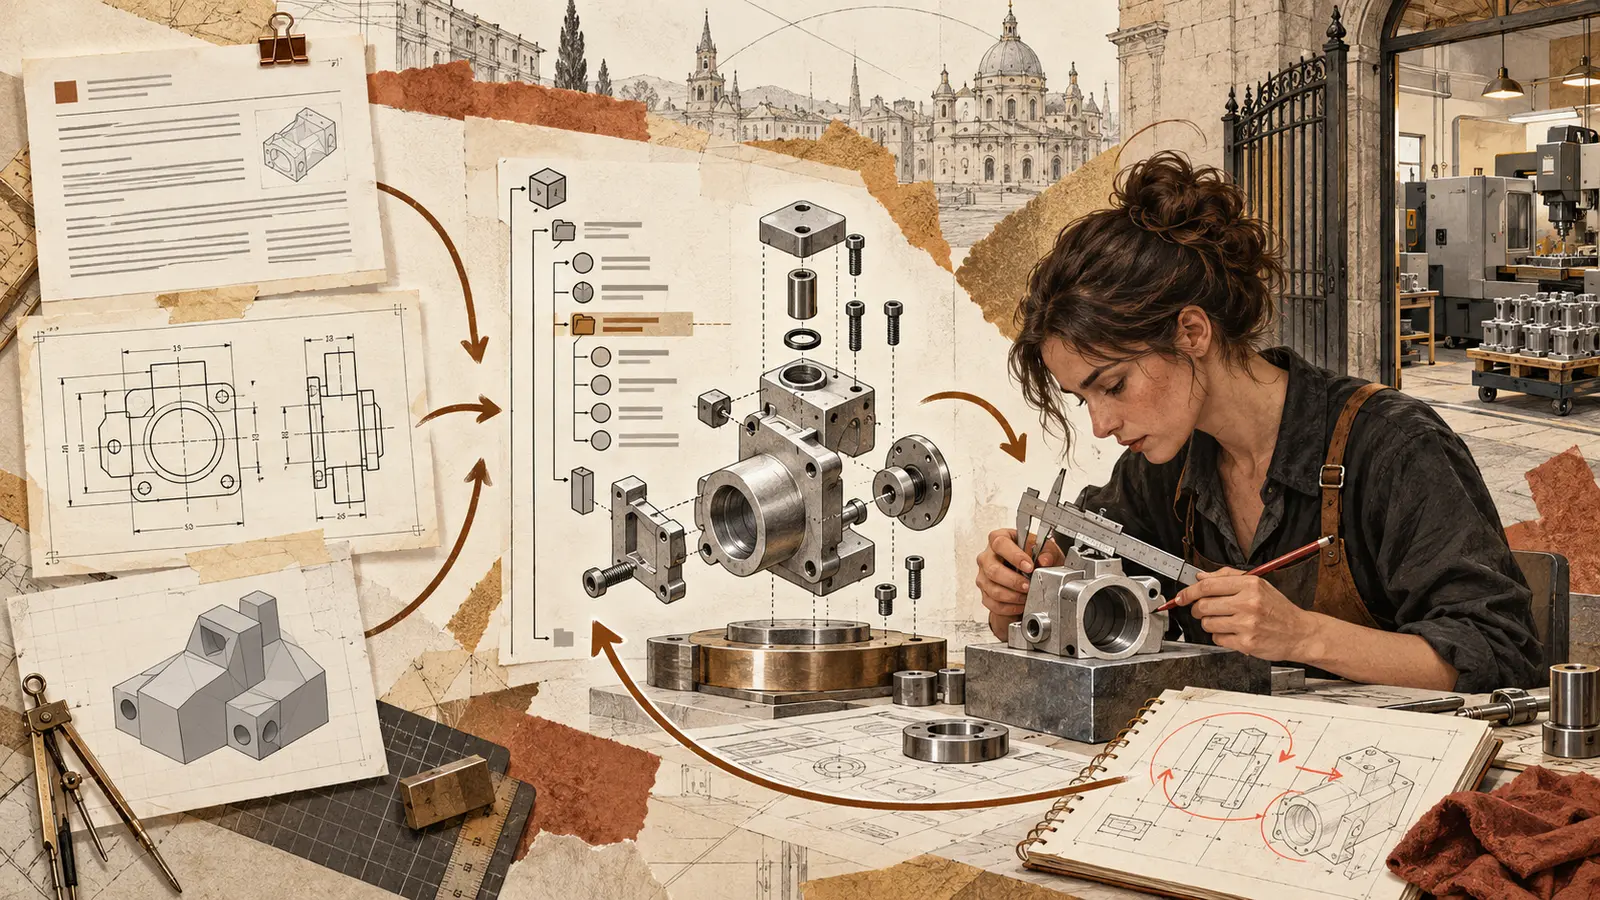
Uma prancha técnica, uma especificação e um arquivo STEP atravessam uma bancada mecânica até formar uma montagem CAD com árvore de recursos; uma engenheira mede a peça antes de liberar a fabricação.
Ilustração conceitual do fluxo. O agente converte diferentes entradas em geometria nativa e editável, mas a saída continua atrás de uma bancada de verificação humana antes de chegar à fabricação.

O MecAgent V2 transforma texto, desenhos e arquivos STEP em peças, montagens e desenhos nativos do SolidWorks. O agente pode atuar na sessão aberta ou executar tarefas longas em segundo plano, preservando a árvore de recursos para edição posterior. A versão está disponível para Windows e SolidWorks 2024 a 2026, mas os resultados de demonstração são do fornecedor e não substituem verificação dimensional, de materiais, tolerâncias e fabricabilidade.

Por que importa. A passagem direta de especificação para geometria editável pode reduzir modelagem repetitiva e manter o trabalho dentro da ferramenta de engenharia. O ganho depende de uma fronteira clara: gerar e automatizar não equivale a validar dimensões, tolerâncias, interfaces, materiais, normas ou segurança do produto.

Ler análise

4 min de leitura

DesignArquiteturaProdutividadeEmpresasAgentesAutomaçãoMultimodalidadeEnterprise

LançamentoAnthropic

Haiku 5.5 barateia tarefas curtas, mas cobra cinco vezes mais depois de 100 mil tokens

Pequenos lotes de documentos atravessam uma máquina compacta, enquanto um arquivo muito longo passa por um limite e recebe cinco contrapesos; uma analista confere as saídas.
Ilustração conceitual da nova curva de custo. Tarefas curtas passam por uma faixa econômica; contextos acima de 100 mil tokens exigem outra conta e avaliação humana da qualidade.

A Anthropic lançou o Claude Haiku 5.5 para classificação, resumo, extração, atendimento e subtarefas de agentes. Em prompts de até 100 mil tokens, custa US$ 0,10 por milhão de tokens de entrada e US$ 0,50 por milhão de saída. Acima desse limite, os valores sobem para US$ 0,50 e US$ 2,50. O modelo está disponível, mas a economia depende de medir o contexto total de cada tarefa.

Por que importa. O lançamento torna viável distribuir tarefas estreitas e repetitivas entre modelos menores, inclusive como subagentes de fluxos mais complexos. A mudança também cria uma armadilha simples: uma tarefa aparentemente barata pode multiplicar o preço quando histórico, anexos e instruções ultrapassam 100 mil tokens.

Ler análise

4 min de leitura

ProdutividadeConhecimentoEmpresasLLMsMultimodalidadeAgentesAPIsEnterprise

LançamentoMistral AI

Mistral Large 4 chega à API antes de liberar seus pesos

Documentos, imagens, gráficos e código atravessam uma grande matriz modular por poucos caminhos ativos; avaliadores medem resultados enquanto módulos fechados aguardam atrás de um portão.
Ilustração conceitual do estágio atual. O preview de API aceita múltiplos formatos e ativa parte da arquitetura por tarefa, enquanto pesos e artefatos prometidos continuam aguardando liberação.

A Mistral colocou o Large 4 em preview público na API em 6 de outubro. O modelo esparso combina 1,05 trilhão de parâmetros totais, 52 bilhões ativos e codificador visual de 1,6 bilhão, segundo a documentação. A Artificial Analysis encontrou desempenho forte em segurança cibernética, mas índice geral abaixo de líderes fechados e custo maior por tarefa. Os pesos ainda não estão disponíveis.

Por que importa. O Large 4 combina contexto longo, visão, uso de ferramentas e especialização em um modelo europeu que já pode ser testado por API. A diferença entre preview utilizável e pesos ainda fechados é decisiva para quem avalia soberania, execução própria, adaptação e auditoria.

Ler análise

4 min de leitura

ProdutividadeConhecimentoEmpresasLLMsMultimodalidadeAgentesAPIsEnterpriseSegurança

Integraçãomnml.ai

mnml leva a visualização arquitetônica para dentro do ChatGPT e do Claude

Arquiteta acompanha um esboço, uma foto de referência e um modelo físico se transformarem em variações de visualização, com enquadramento, ficha de aprovação e saídas para imagem e vídeo.
Ilustração conceitual do fluxo conversacional. Esboço, foto ou vista de modelo orientam variações e refinamentos; a entrega visual não altera o modelo CAD ou BIM de origem.

A mnml.ai lançou um servidor MCP para criar, refinar, ampliar e animar visualizações arquitetônicas dentro do ChatGPT, Claude e outros assistentes compatíveis. O conector está disponível globalmente, inclusive para contas gratuitas, com aprovação antes de gastar créditos e limites diários. No ChatGPT, o acesso depende do modo desenvolvedor até a entrada no diretório de aplicativos.

Por que importa. A integração aproxima briefing, referências, geração e revisão visual no mesmo diálogo. Para arquitetura e interiores, isso reduz troca de contexto e preserva o histórico do projeto, mas a imagem continua sendo uma interpretação que precisa ser comparada com geometria, materiais e decisões aprovadas.

Ler análise

4 min de leitura

ArquiteturaDesignCriatividadeProdutividadeImagemVídeoMultimodalidadeIntegraçãoAutomação

Nova capacidadeFlux

Flux transforma o PCB em um gabinete 3D sincronizado

Placa de circuito e peças de um gabinete 3D aparecem em vista explodida, ligadas por linhas de alinhamento a portas, suportes e ventilação, enquanto uma mão verifica um encaixe.
Ilustração conceitual do fluxo integrado. A geometria do PCB orienta o gabinete e suas aberturas; a peça impressa continua exigindo verificação de tolerância, calor, montagem e resistência.

O Flux passou a gerar gabinetes 3D a partir do PCB que já está no projeto. A ferramenta cria recortes, standoffs, tampas, ventilação e encaixes, atualiza o invólucro quando a placa muda e exporta para impressão 3D. A capacidade está disponível em todos os planos, com teste de duas semanas, mas alegações de encaixe e redução de prazo vêm do fornecedor.

Por que importa. O invólucro costuma separar projeto eletrônico e projeto mecânico, com arquivos estáticos e retrabalho a cada mudança. O Flux tenta manter os dois lados no mesmo modelo. Para produto, prototipagem e instalações, isso pode encurtar a primeira peça física, desde que o gabinete gerado seja tratado como hipótese verificável, não como projeto pronto para produção.

Ler análise

3 min de leitura

DesignCriatividadeProdutividadeAgentesAutomaçãoMultimodalidadeIntegração

LançamentoMicrosoft AI

Microsoft leva voz em tempo real ao preview com português documentado

Em um estúdio de arquitetura, a fala de uma profissional se transforma em ondas, fragmentos de transcrição e cartões de ação antes de retornar como voz por uma pequena caixa de som.
Ilustração conceitual do ciclo de voz em tempo real. Hipóteses parciais chegam antes do fim da fala, mas precisam estabilizar antes de virar registro ou ação.

A Microsoft lançou em preview público o MAI-Transcribe-2-Streaming, seu primeiro modelo da família MAI para transcrição contínua. Ele recebe áudio em fluxo, revisa hipóteses parciais e confirma segmentos finais em 60 idiomas. Com MAI-Voice-2.1 e Flash, completa um pipeline de agentes de voz, legendas e ditado; português aparece na documentação, mas o preview não é recomendado para produção.

Por que importa. Interfaces de voz podem começar a legendar, registrar ou preparar uma ação antes do fim da frase. Para atendimento, reuniões, aulas e acessibilidade, a promessa é reduzir espera; o teste profissional precisa medir erro e latência com português brasileiro, ruído e vocabulário real antes de qualquer uso crítico.

Ler análise

3 min de leitura

ProdutividadeConhecimentoEmpresasNegóciosÁudioMultimodalidadeAgentesAPIs

LançamentoCloudflare

Clef troca texto livre por decisões tipadas dentro de agentes

Uma máquina tátil de latão recebe texto, imagem e amostra de material, pondera evidências e distribui fichas entre gavetas de decisão; um caso ambíguo segue para revisão humana.
Ilustração conceitual de decisões tipadas. A saída estruturada simplifica o roteamento, mas casos ambíguos continuam precisando de limiar, fallback e revisão.

A Cloudflare lançou Clef e Clef-flash, modelos multimodais especializados em decisões fechadas. Em vez de redigir uma resposta, recebem um estado e perguntas tipadas e devolvem probabilidades para sim ou não, escolha ou score. Os modelos estão disponíveis no Workers AI e com pesos abertos; o serviço de ajuste por reforço ainda opera com parceiros de design.

Por que importa. Triagem, roteamento, classificação visual e checagens de política nem sempre precisam de um parágrafo. Uma saída tipada pode reduzir parsing, custo e latência, mas também automatizar um erro em escala; a probabilidade precisa ser calibrada no domínio real e ligada a revisão nos casos de maior impacto.

Ler análise

3 min de leitura

ProdutividadeEmpresasNegóciosConhecimentoAgentesAutomaçãoAPIsMultimodalidade

LançamentoEloelo Group

Dolphin coordena roteiro, planos e continuidade num estúdio de vídeo

Um roteiro de papel percorre seis pequenos sets de filmagem conectados, repetindo a mesma personagem e o mesmo interior em planos gerais, médios e detalhes até chegar ao corte final.
Ilustração conceitual de uma produção multishot. A promessa é preservar mundo, personagem e direção entre planos; a consistência ainda precisa ser testada fora das demonstrações.

O Eloelo Group abriu em preview o Dolphin AI, um estúdio agêntico que transforma roteiro em produção multishot e reúne planejamento, geração, voz, música, edição e melhoria. O sistema promete manter personagem, figurino, objeto, local e estilo entre planos. O acesso é antecipado, sem preço, SLA ou benchmark independente de continuidade.

Por que importa. O gargalo do vídeo gerado já não é apenas criar um clipe, mas coordenar roteiro, ativos, continuidade, som e revisão numa peça com começo, meio e fim. O Dolphin tenta assumir essa camada de produção; como o acesso é restrito e os resultados vêm do fornecedor, o valor real precisa ser medido projeto a projeto.

Ler análise

3 min de leitura

CriatividadeDesignProdutividadeNegóciosVídeoÁudioImagemAgentesMultimodalidade

Nova capacidadeBackflip AI

Backflip reconstrói desenhos 2D como CAD paramétrico editável

Uma prancha técnica com vistas ortográficas se transforma em uma peça tridimensional por uma sequência visível de operações paramétricas, sob revisão de uma engenheira.
Ilustração conceitual da passagem de desenho 2D para CAD paramétrico. A árvore de operações pode ser editada; medidas e intenção de projeto ainda precisam de revisão técnica.

A Backflip lançou Drawing to CAD em 17 de setembro. A ferramenta interpreta vistas e cotas de desenhos técnicos 2D e monta um modelo 3D com árvore de recursos editável no Autodesk Fusion. O serviço está disponível no aplicativo web e no add-in do Fusion; o web exporta STEP, enquanto integrações nativas com outros sistemas CAD seguem em desenvolvimento.

Por que importa. Arquivos legados em 2D ainda guardam conhecimento de peças, equipamentos e edifícios. Transformá-los em geometria editável pode reduzir reconstrução manual e facilitar manutenção. O valor depende de preservar medidas, relações e intenção de projeto, não apenas de produzir uma forma visualmente parecida.

Ler análise

3 min de leitura

DesignArquiteturaProdutividadeEmpresasMultimodalidadeAutomação

LançamentoAlibaba Cloud

Qwen reúne áudio, vídeo e ferramentas em um contexto de 1 milhão de tokens

Um corredor de arquivo recebe páginas, imagens, ondas sonoras e quadros de vídeo, organiza o material em uma sequência longa e o conecta a estações de pesquisa e ferramentas.
Ilustração conceitual da entrada multimodal, do contexto longo e do uso de ferramentas. A imagem não representa uma medição de desempenho nem garante retenção fiel de todo o material.

A Alibaba Cloud disponibilizou o Qwen3.8-Omni-Flash, modelo que recebe texto, imagem, áudio e vídeo e devolve texto. A API combina janela de contexto de 1 milhão de tokens, chamadas de ferramentas, pesquisa na web e cache. Uma variante separada, liberada depois, acrescenta interação audiovisual em tempo real e saída de áudio.

Por que importa. A combinação reduz a necessidade de separar transcrição, leitura de imagens e análise de vídeo em modelos diferentes. Para trabalho profissional, o valor dependerá menos do tamanho anunciado da janela e mais da capacidade de localizar a evidência certa, citar o trecho usado e acionar ferramentas sem perder controle.

Ler análise

3 min de leitura

ConhecimentoProdutividadeCriatividadeMultimodalidadeLLMsAgentesAPIs