IA Lab by amano
Radar de IA

O que mudou em IA e o que realmente importa

Uma curadoria do IA Lab sobre mudanças que podem afetar criatividade, arquitetura, design, negócios, produtividade e empresas.

18 entradas encontradas

AtualizaçãoGoogle

Gemini 4 Argon chega à API e às assinaturas com acesso e preços diferentes
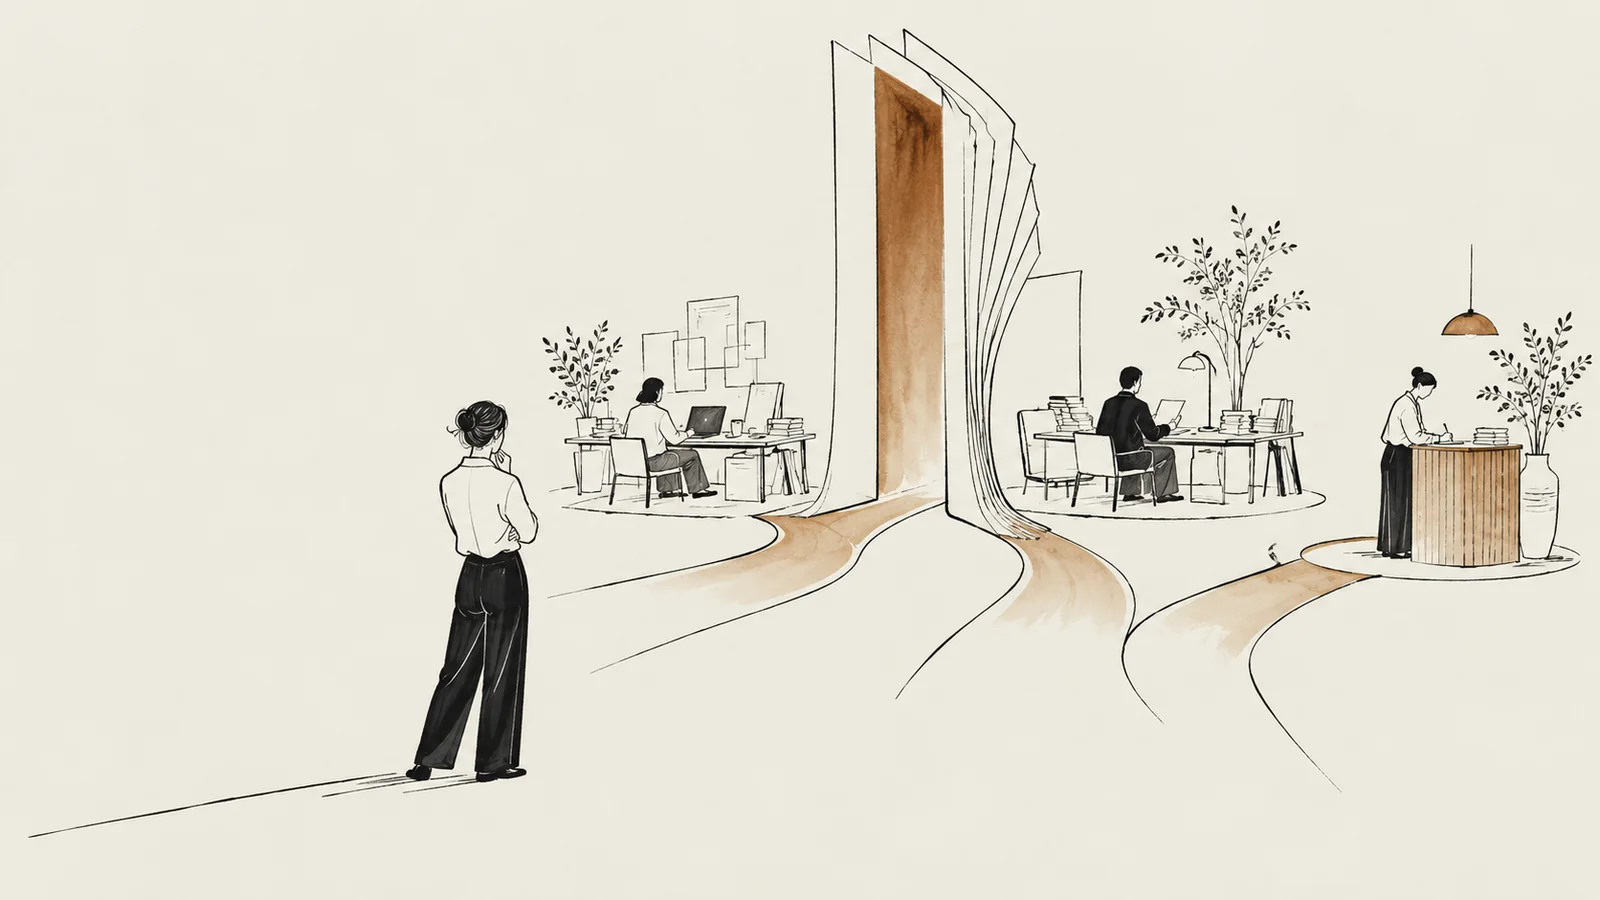
Uma profissional compara três rotas que partem de um portal aberto para diferentes espaços de trabalho.
Ilustração conceitual da nova fase do Gemini 4 Argon. O acesso foi ampliado, mas API, aplicativo e agente seguem rotas distintas.

O Google liberou o Gemini 4 Argon para desenvolvedores e empresas pela API e para assinantes Pro ou Ultra em produtos selecionados. A API paga começa em US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de saída até 30 de novembro; depois, os valores dobram. A mudança torna o modelo testável, mas cada canal oferece recursos e condições próprias.

Por que importa. A disponibilidade real permite comparar o modelo em tarefas profissionais, custo e supervisão. A escolha, porém, não termina no nome do modelo: canal, plano, limite, ferramenta disponível e regra de retenção continuam fazendo parte da decisão.
Ler análise

4 min de leitura

ConhecimentoProdutividadeEmpresasNegóciosLLMsAgentesAPIsEnterpriseSegurança

LançamentoMeta

Muse Wonder chega à API com agentes de longa duração, enquanto a versão Full fica na assinatura

Um arquivo alto alimenta dois fluxos de agentes: uma rota aberta por um portal de API e outra que entra numa oficina reservada, enquanto uma profissional supervisiona o conjunto.
Ilustração conceitual do acesso dividido. Muse Wonder entra na API e no ambiente de programação; Wonder Full permanece dentro dos planos superiores do Muse Code.

A Meta lançou Muse Wonder e Muse Wonder Full para programação, agentes de longa duração e uso de computador. Wonder está disponível na Meta Model API e no Muse Code, com contexto de um milhão de tokens e preço público por token. Full fica restrito aos planos Power e Maximum do Muse Code, sem API pública ou preço por token. Uma avaliação independente coloca os dois entre os modelos de maior pontuação, mas também aponta custo e verbosidade relevantes.

Por que importa. A novidade combina contexto longo, coordenação de subagentes e uso de computador em um produto disponível. Para equipes, a decisão não depende apenas do desempenho: canal de acesso, custo, revisão humana e possibilidade de trocar de fornecedor mudam entre as duas versões.

Ler análise

4 min de leitura

ProdutividadeConhecimentoEmpresasLLMsAgentesAutomaçãoAPIsEnterprise

LançamentoGoogle DeepMind

EmbeddingGemma 2 leva busca multimodal para o dispositivo, mas português ainda pede teste

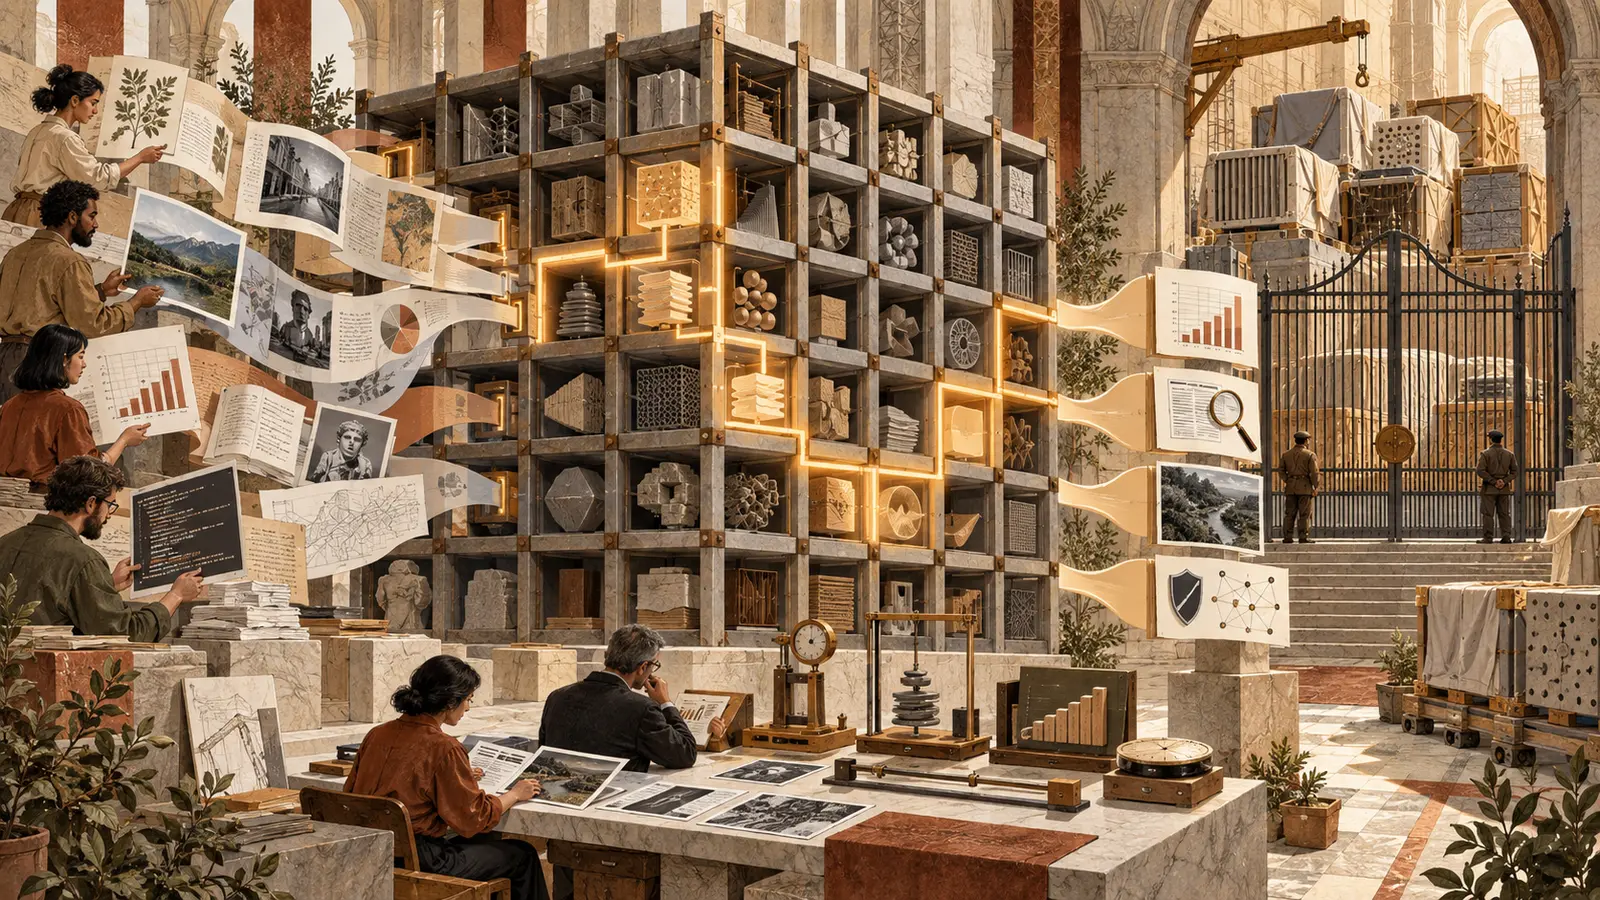
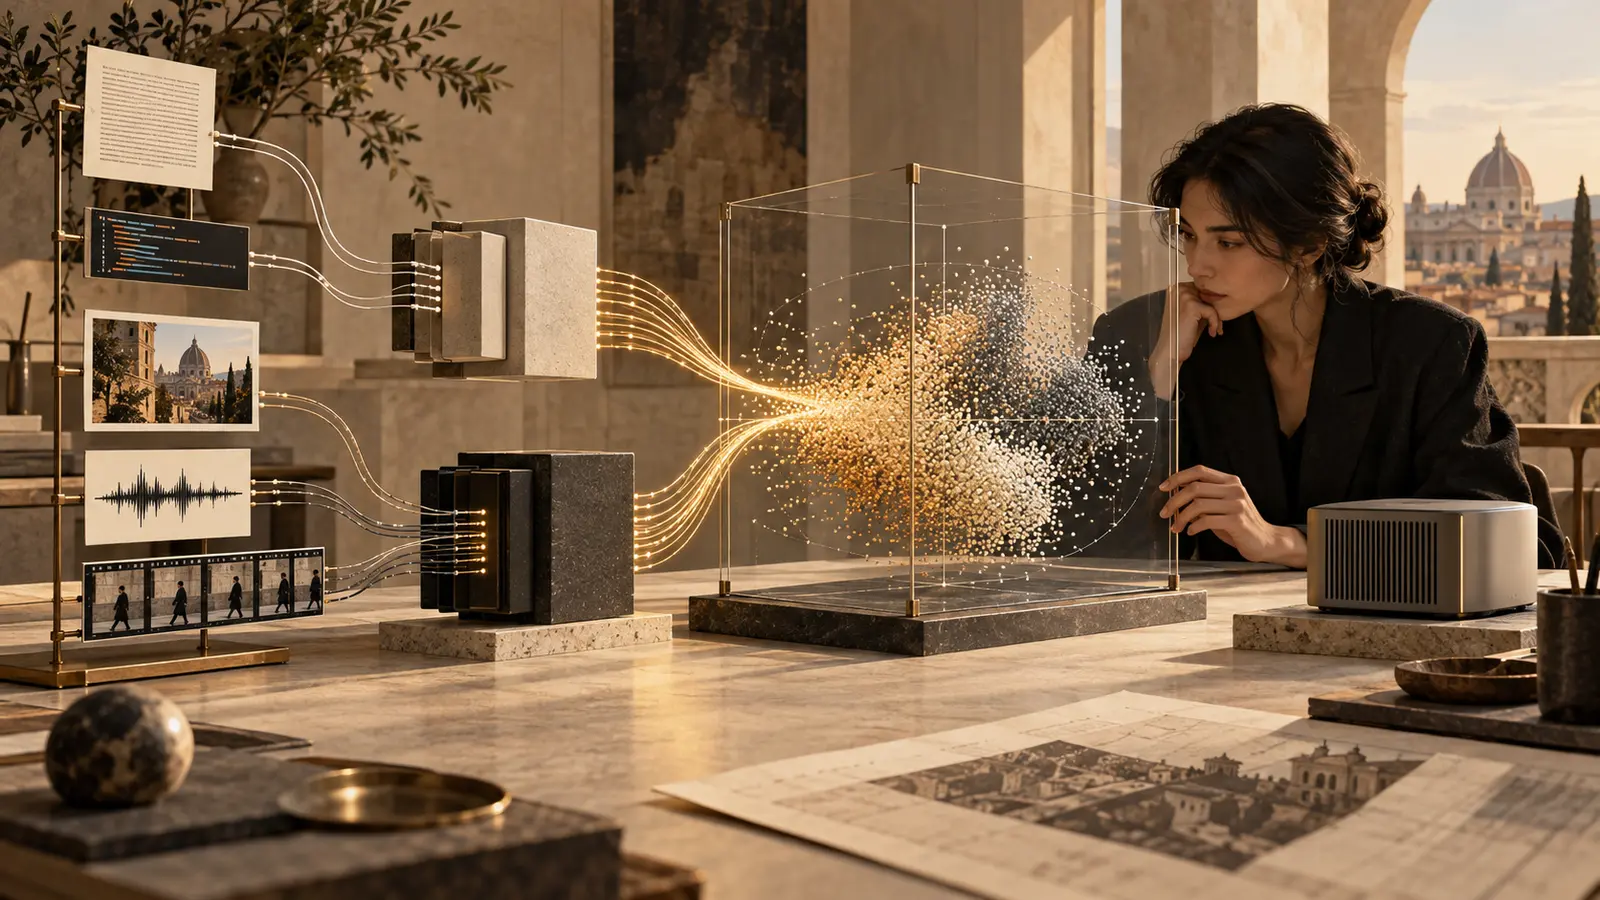
Uma mesa de arquivo recebe página, imagem, faixa de áudio e sequência de vídeo; cada mídia atravessa módulos físicos e chega a um mapa comum de pontos, revisado por uma pesquisadora.
Ilustração conceitual da busca multimodal local. Mídias diferentes viram representações comparáveis no mesmo mapa, enquanto a equipe testa idioma, precisão e custo de armazenamento antes de usar o resultado.

O Google lançou o EmbeddingGemma 2, um modelo aberto de 740 milhões de parâmetros para busca, classificação e recuperação multimodal no próprio dispositivo. Texto, código, imagem, vídeo e áudio entram no mesmo espaço vetorial, com encoders modulares e saídas que podem ser reduzidas para economizar armazenamento. Os pesos estão disponíveis sob Apache 2.0, mas os resultados publicados são do fornecedor e ainda não demonstram qualidade específica em português brasileiro.

Por que importa. Busca semântica local deixa de ficar limitada a texto. Escritórios podem indexar acervos de documentos, imagens, vídeos e áudios sem enviar cada consulta a uma API externa, mas a utilidade depende de testes com o próprio repertório, idioma e hardware.

Ler análise

3 min de leitura

ConhecimentoProdutividadeEmpresasMultimodalidadePesquisaLLMsPrivacidade

AtualizaçãoONLYOFFICE

ONLYOFFICE 10 leva IA ao contexto de documentos, planilhas, apresentações e PDFs

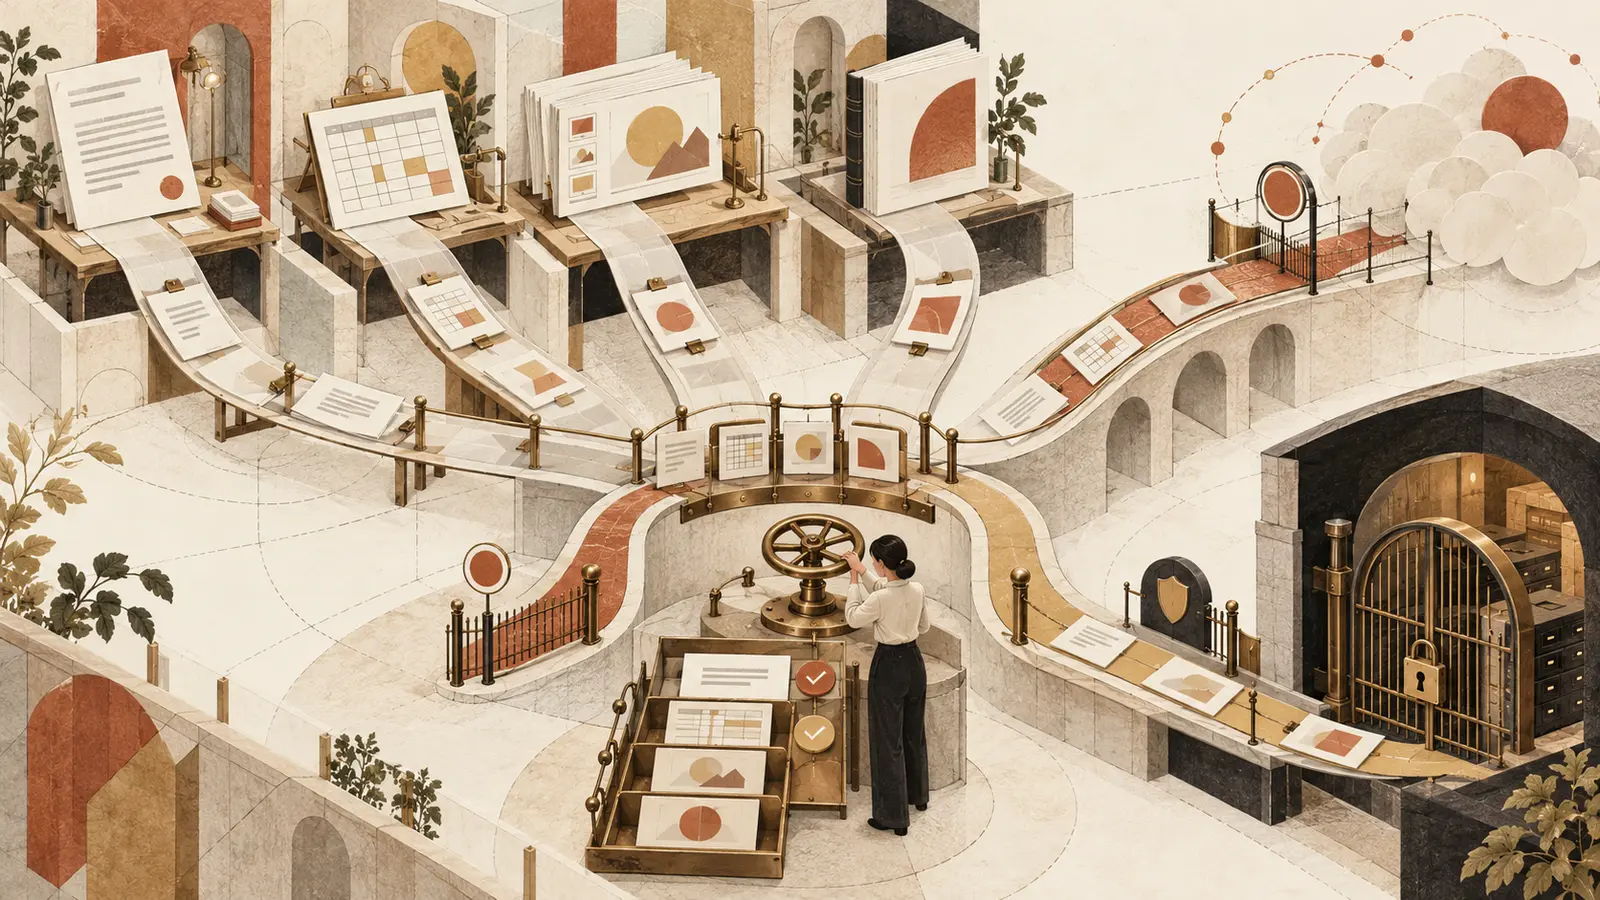
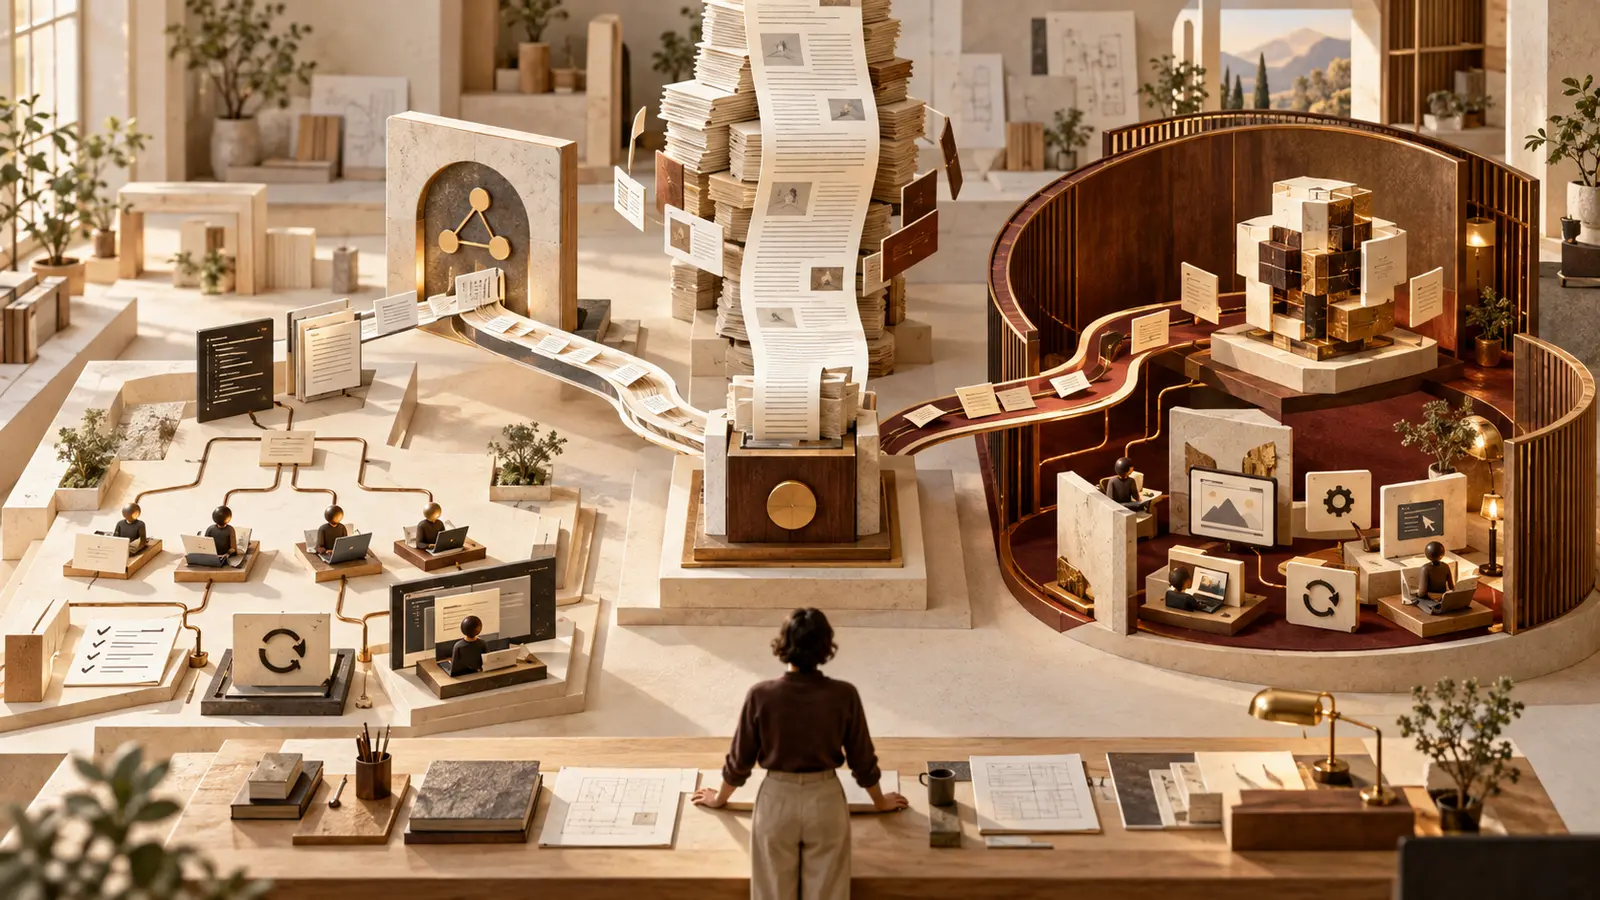
Quatro mesas conectadas contêm um contrato, uma planilha, uma apresentação e um PDF; um trilho de contexto leva as páginas até diferentes modelos, com válvulas de escolha e um arquivo local fechado.
Ilustração conceitual da arquitetura. O contexto permanece ligado a cada tipo de arquivo, enquanto a equipe escolhe o modelo e decide se o processamento sai da infraestrutura ou fica num ambiente local.

O ONLYOFFICE Docs 10.0 colocou chat e ferramentas de IA dentro dos editores de texto, planilha, apresentação e PDF. A versão trabalha com o contexto do arquivo, aceita prompts salvos e permite escolher modelos por tarefa. Na nuvem, o serviço pode ser ativado via OpenRouter; em instalações de servidor, a organização pode conectar provedores externos ou modelos locais. A IA é opcional e instalada separadamente nas versões open source.

Por que importa. A IA deixa de exigir cópia manual entre chat e arquivo e passa a operar dentro do fluxo documental. Isso pode acelerar leitura, redação e análise, mas também torna mais importante saber qual conteúdo foi enviado, para qual modelo, sob qual política e com que possibilidade de revisão.

Ler análise

4 min de leitura

ProdutividadeConhecimentoEmpresasNegóciosCriatividadeAutomaçãoLLMsIntegraçãoPrivacidadeEnterprise

LançamentoAnthropic

Haiku 5.5 barateia tarefas curtas, mas cobra cinco vezes mais depois de 100 mil tokens

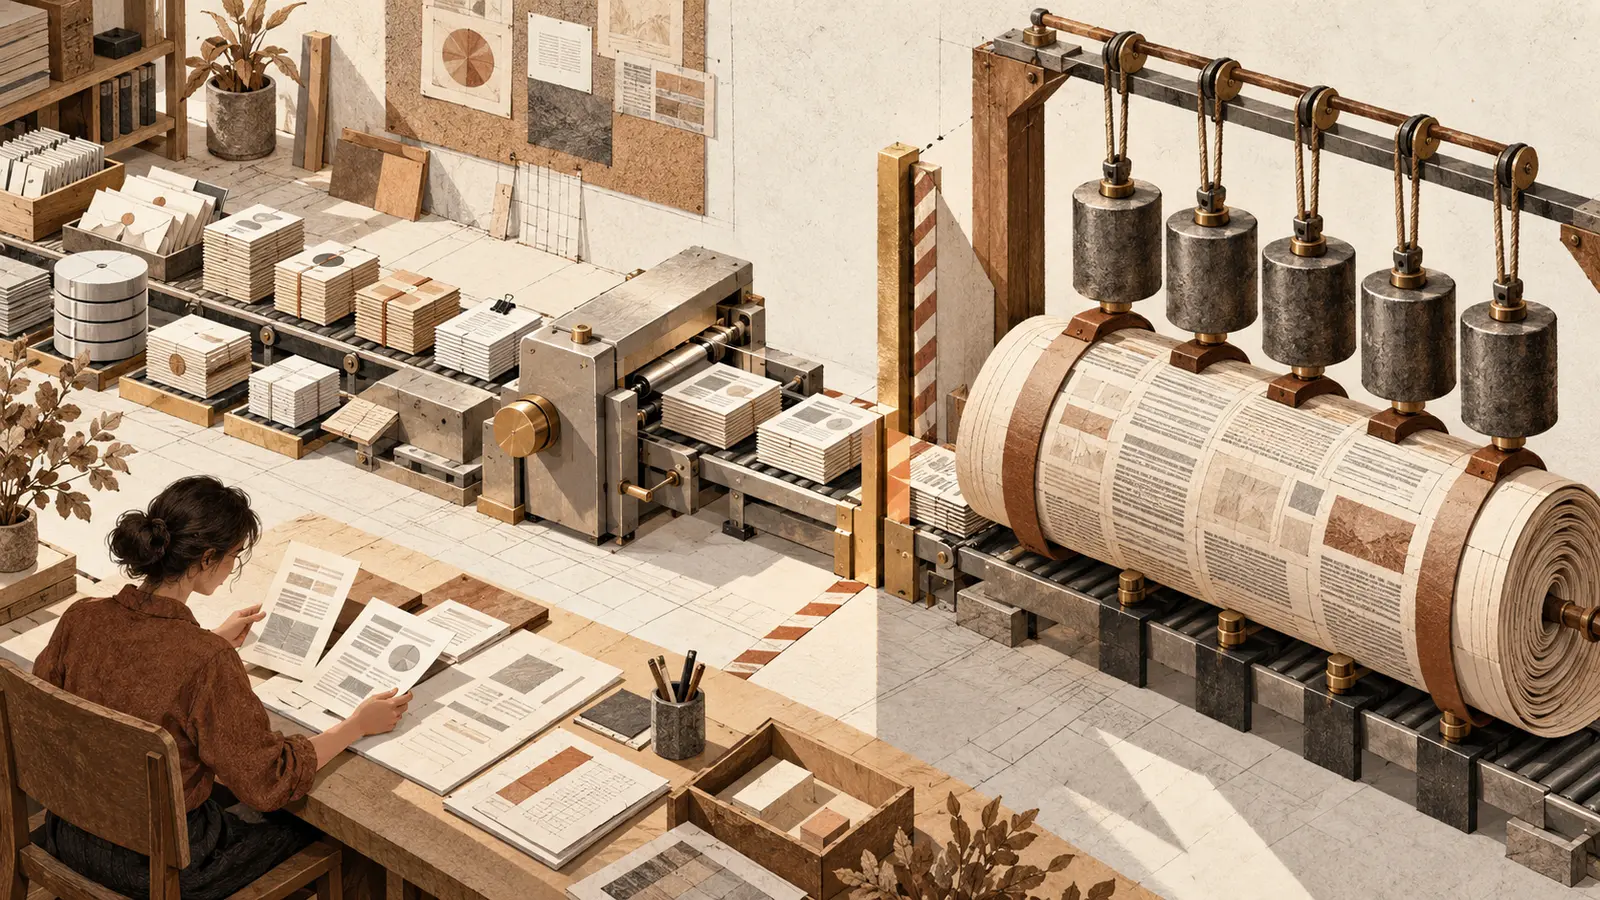
Pequenos lotes de documentos atravessam uma máquina compacta, enquanto um arquivo muito longo passa por um limite e recebe cinco contrapesos; uma analista confere as saídas.
Ilustração conceitual da nova curva de custo. Tarefas curtas passam por uma faixa econômica; contextos acima de 100 mil tokens exigem outra conta e avaliação humana da qualidade.

A Anthropic lançou o Claude Haiku 5.5 para classificação, resumo, extração, atendimento e subtarefas de agentes. Em prompts de até 100 mil tokens, custa US$ 0,10 por milhão de tokens de entrada e US$ 0,50 por milhão de saída. Acima desse limite, os valores sobem para US$ 0,50 e US$ 2,50. O modelo está disponível, mas a economia depende de medir o contexto total de cada tarefa.

Por que importa. O lançamento torna viável distribuir tarefas estreitas e repetitivas entre modelos menores, inclusive como subagentes de fluxos mais complexos. A mudança também cria uma armadilha simples: uma tarefa aparentemente barata pode multiplicar o preço quando histórico, anexos e instruções ultrapassam 100 mil tokens.

Ler análise

4 min de leitura

ProdutividadeConhecimentoEmpresasLLMsMultimodalidadeAgentesAPIsEnterprise

LançamentoMistral AI

Mistral Large 4 chega à API antes de liberar seus pesos

Documentos, imagens, gráficos e código atravessam uma grande matriz modular por poucos caminhos ativos; avaliadores medem resultados enquanto módulos fechados aguardam atrás de um portão.
Ilustração conceitual do estágio atual. O preview de API aceita múltiplos formatos e ativa parte da arquitetura por tarefa, enquanto pesos e artefatos prometidos continuam aguardando liberação.

A Mistral colocou o Large 4 em preview público na API em 6 de outubro. O modelo esparso combina 1,05 trilhão de parâmetros totais, 52 bilhões ativos e codificador visual de 1,6 bilhão, segundo a documentação. A Artificial Analysis encontrou desempenho forte em segurança cibernética, mas índice geral abaixo de líderes fechados e custo maior por tarefa. Os pesos ainda não estão disponíveis.

Por que importa. O Large 4 combina contexto longo, visão, uso de ferramentas e especialização em um modelo europeu que já pode ser testado por API. A diferença entre preview utilizável e pesos ainda fechados é decisiva para quem avalia soberania, execução própria, adaptação e auditoria.

Ler análise

4 min de leitura

ProdutividadeConhecimentoEmpresasLLMsMultimodalidadeAgentesAPIsEnterpriseSegurança

LançamentoReflection AI

Beam promete um modelo aberto eficiente, mas os pesos ainda não chegaram

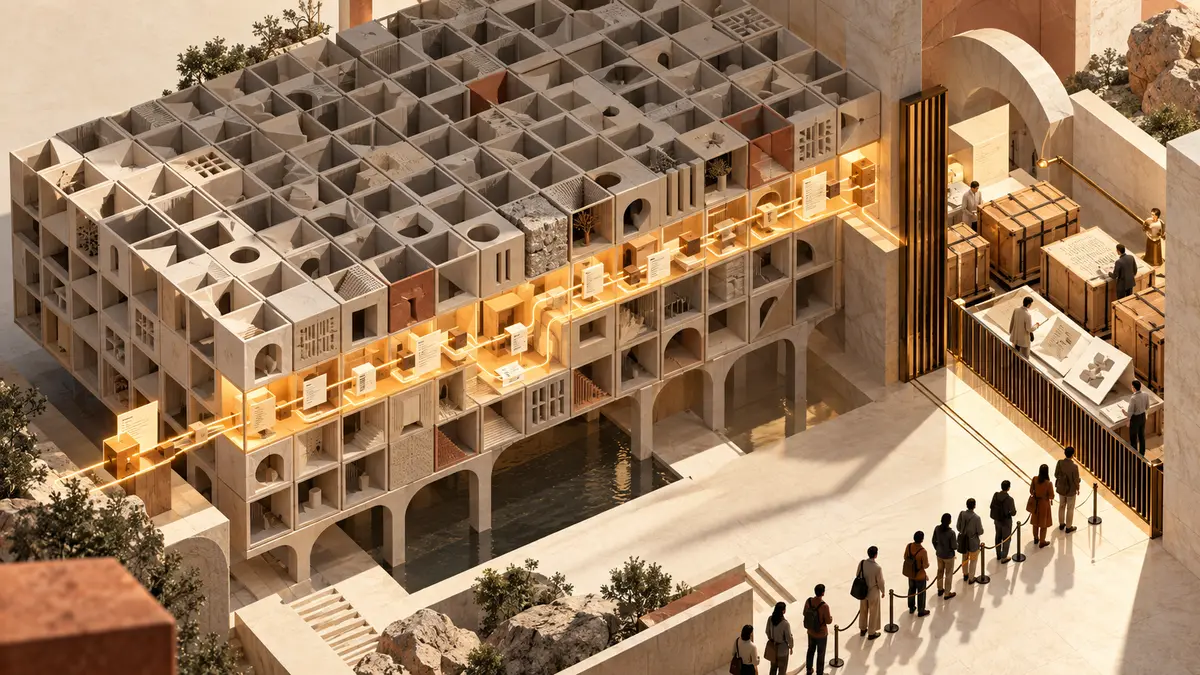
Uma grande matriz arquitetônica mantém apenas um corredor iluminado em atividade, enquanto caixas de pesos, relatório técnico e ficha do modelo aguardam inspeção atrás de um portão.
Ilustração conceitual do estágio atual. Uma parte pequena da estrutura é ativada por tarefa, mas pesos e documentação continuam atrás do portão de testes finais.

A Reflection AI apresentou o Beam, modelo de texto com arquitetura esparsa voltado a código, raciocínio e agentes. A empresa informa 501 bilhões de parâmetros totais e 23 bilhões ativos por token, mas o modelo ainda está em desenvolvimento: só há lista de acesso antecipado e os pesos não podem ser baixados. Benchmarks e alegações de eficiência são do fornecedor e não tiveram reprodução independente.

Por que importa. Modelos com pesos disponíveis podem ser executados e adaptados em infraestrutura própria, o que muda custo, controle e auditoria. Beam ainda não oferece essa possibilidade. Por enquanto, a notícia é uma promessa técnica acompanhada de acesso restrito, não uma alternativa pronta para implantação.

Ler análise

4 min de leitura

ConhecimentoProdutividadeEmpresasLLMsAgentesAPIsEnterprise

LançamentoAi2

AstaBrief transforma evidências recuperadas em relatórios científicos citados

Pesquisadora conecta um conjunto delimitado de trechos científicos a um relatório por uma máquina de papel e latão, com cada citação ligada visualmente à evidência de origem.
Ilustração conceitual do escopo do AstaBrief. O modelo organiza trechos previamente recuperados em um relatório citado; busca, seleção da literatura e validação científica continuam sendo etapas separadas.

A Ai2 publicou o AstaBrief 8B, modelo aberto que recebe uma pergunta de pesquisa e trechos científicos já recuperados para redigir um relatório com citações. Ele foi desenhado para uma etapa específica do fluxo, depois da busca e antes da revisão. A empresa relata velocidade cerca de 3,5 vezes maior que o modo Thinking do Asta, mas reconhece avaliação estreita, majoritariamente executada em 2025.

Por que importa. Relatórios de tendências, revisões rápidas e notas técnicas gastam tempo na passagem de evidências dispersas para uma narrativa verificável. AstaBrief oferece uma peça aberta para essa etapa, mas não substitui busca, leitura crítica nem checagem do alcance de cada citação. O teste útil mede rastreabilidade e distorção, não apenas fluência.

Ler análise

4 min de leitura

ConhecimentoProdutividadeEmpresasLLMsPesquisa

LançamentoOpenAI

GPT-6.1 Sol aproxima desempenho de topo com custo menor, mas acesso segue fragmentado

Três profissionais trabalham com código, documentos e fluxos conectados ao mesmo núcleo computacional; uma balança compara capacidade e custo, enquanto uma porta comum permanece fechada.
Ilustração conceitual da proposta do GPT-6.1 Sol. O mesmo contexto alimenta tarefas profissionais distintas, mas o acesso continua separado entre Work, Codex e API.

A OpenAI lançou o GPT-6.1 Sol em 29 de setembro para trabalho profissional, programação agêntica, uso de computador e pesquisa. A empresa o posiciona perto do GPT-6 Astra por uma fração do preço. O Vals Index confirma uma relação custo-desempenho melhor nesse conjunto, sem provar superioridade geral nem segurança automática.

Por que importa. A mudança prática não é apenas uma nova pontuação, mas o custo por tarefa longa e revisável. Um modelo intermediário mais capaz pode ampliar testes de agentes e documentos, desde que a equipe meça resultado final, supervisão, risco e disponibilidade no produto que realmente usa.

Ler análise

4 min de leitura

ConhecimentoProdutividadeEmpresasNegóciosLLMsAgentesAutomaçãoEnterpriseAPIsSegurança

LançamentoGoogle

Gemini 4 Argon estreia em preview fechado para ciberdefensores

Um núcleo computacional fica protegido dentro de uma câmara de acesso controlado, onde três especialistas examinam documentos; um grande salão público permanece vazio do lado de fora.
Ilustração conceitual do acesso restrito ao Gemini 4 Argon. O modelo foi apresentado, mas o uso inicial permanece limitado a ciberdefensores e testers selecionados.

O Google apresentou o Gemini 4 Argon em 30 de setembro. A primeira coorte reúne ciberdefensores e testers selecionados no programa Fairwind; API paga e Google AI Ultra aparecem como próximos passos, sem cronograma. O modelo liderou a edição consultada do Vals Index, mas parte importante da evidência de desempenho continua sendo autorreportada pelo fornecedor.

Por que importa. Argon sinaliza a próxima geração do Gemini para engenharia, trabalho profissional e defesa cibernética. Para decisões de compra, porém, anúncio e benchmark não equivalem a disponibilidade: hoje não há endpoint público, prazo geral ou teste amplo em fluxos reais de equipes brasileiras.

Ler análise

4 min de leitura

ConhecimentoProdutividadeEmpresasNegóciosLLMsSegurançaEnterpriseAPIs

LançamentoAnthropic

Sonnet 5.5 reduz preço e promete fazer mais trabalho com menos tokens

Uma editora revisa uma sequência compacta de documentos, código e planilhas, enquanto uma bancada maior e mais carregada aparece ao fundo.
Ilustração conceitual da proposta de eficiência do Sonnet 5.5. Menos etapas e tokens são hipóteses para medir no fluxo da equipe, não garantias de resultado.

A Anthropic lançou Claude Sonnet 5.5 em 28 de setembro como opção para tarefas cotidianas de programação, agentes e trabalho de conhecimento. O modelo custa US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída e já está disponível no Claude, na API e em três serviços de nuvem. As alegações de menor uso de tokens e melhor desempenho vêm da empresa e de clientes selecionados.

Por que importa. Preço por token não revela sozinho o custo de uma tarefa. Se um modelo chegar a uma resposta revisável com menos tokens, chamadas de ferramenta e correções, pode reduzir espera e gasto em rotinas repetidas. A decisão deve comparar custo total, qualidade e revisão humana no mesmo conjunto de trabalho.

Ler análise

4 min de leitura

ProdutividadeConhecimentoEmpresasLLMsAgentesEnterprise

PesquisaAustrian Academy of Sciences

Apollo propõe lacunas em textos gregos antigos, sem retirar a decisão dos especialistas

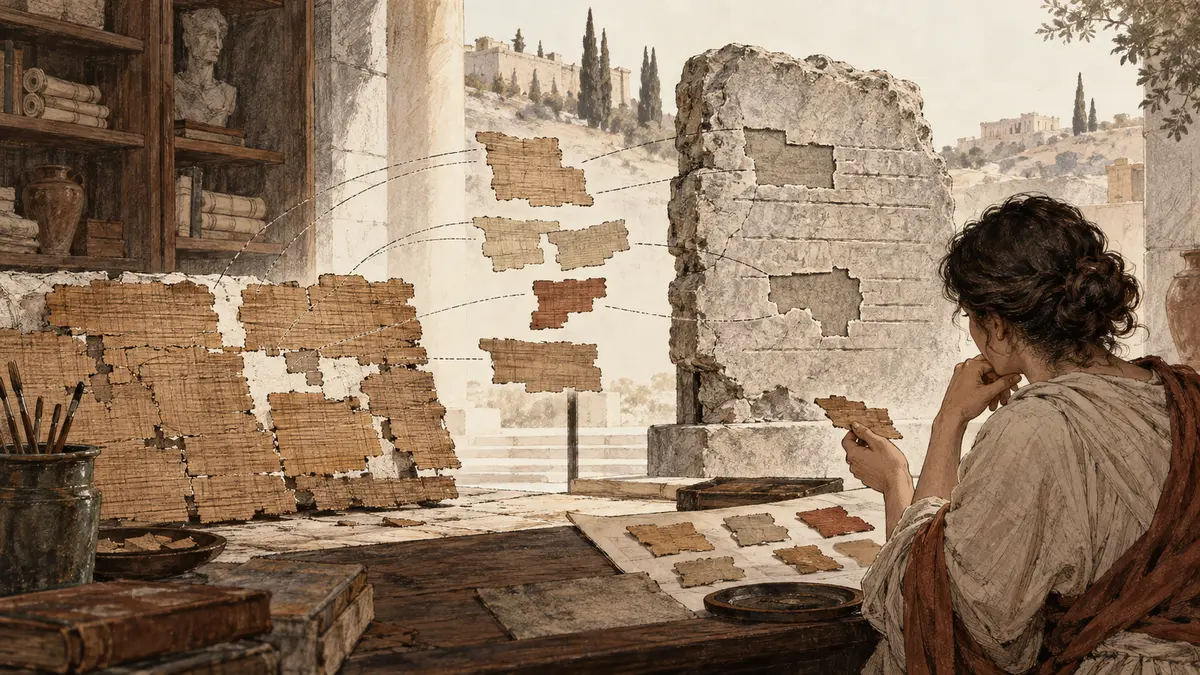
Uma pesquisadora compara fragmentos candidatos para preencher lacunas em um papiro e em uma inscrição de pedra, mantendo a revisão humana no centro da cena.
Ilustração conceitual do uso de sugestões para restaurar trechos ausentes. Apollo oferece candidatos; a escolha e a interpretação continuam dependentes de especialistas e evidências.

A Academia Austríaca de Ciências, a Mistral AI, a SAIL Reply e a Northeastern University apresentaram o Apollo Restore, modelo de 24 bilhões de parâmetros treinado para sugerir preenchimentos de lacunas em papiros, inscrições e manuscritos em grego histórico. A aplicação é gratuita e aberta, mas cada proposta ainda exige validação filológica e histórica.

Por que importa. Apollo mostra uma direção diferente dos assistentes gerais: modelos menores, ajustados a um domínio e ligados a um método de trabalho específico. O interesse não está em completar textos automaticamente, mas em ampliar o conjunto de hipóteses que especialistas conseguem examinar e documentar.

Ler análise

3 min de leitura

ConhecimentoCriatividadeLLMsPesquisa