IA Lab by amano
Radar de IA

O que mudou em IA e o que realmente importa

Uma curadoria do IA Lab sobre mudanças que podem afetar criatividade, arquitetura, design, negócios, produtividade e empresas.

17 entradas encontradas

AtualizaçãoGoogle

Gemini 4 Argon chega à API e às assinaturas com acesso e preços diferentes
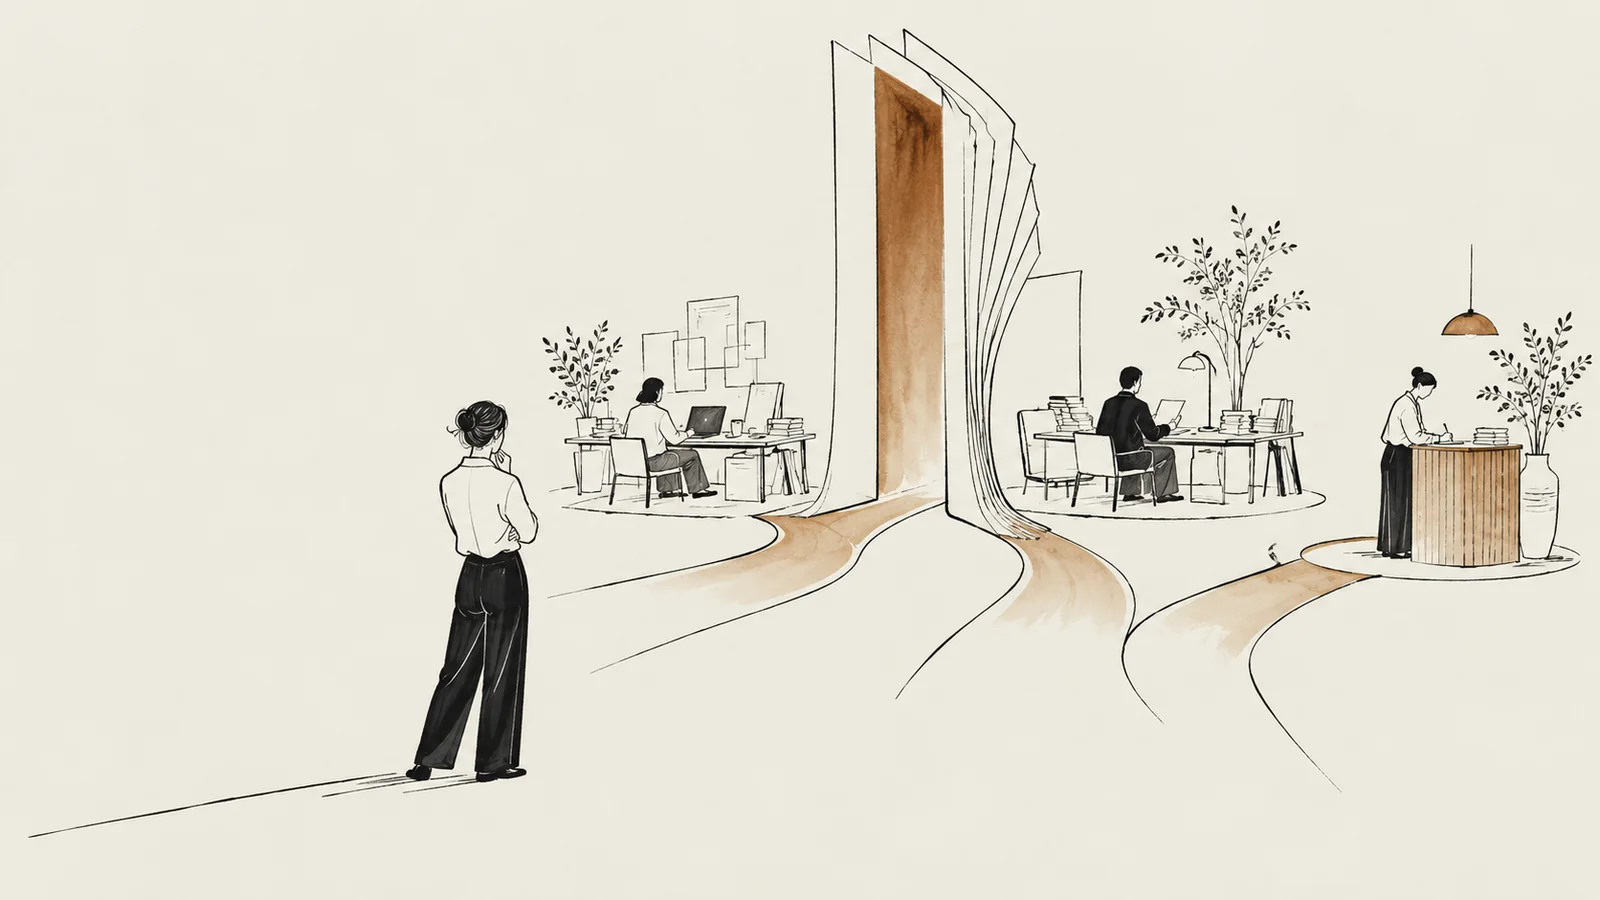
Uma profissional compara três rotas que partem de um portal aberto para diferentes espaços de trabalho.
Ilustração conceitual da nova fase do Gemini 4 Argon. O acesso foi ampliado, mas API, aplicativo e agente seguem rotas distintas.

O Google liberou o Gemini 4 Argon para desenvolvedores e empresas pela API e para assinantes Pro ou Ultra em produtos selecionados. A API paga começa em US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de saída até 30 de novembro; depois, os valores dobram. A mudança torna o modelo testável, mas cada canal oferece recursos e condições próprias.

Por que importa. A disponibilidade real permite comparar o modelo em tarefas profissionais, custo e supervisão. A escolha, porém, não termina no nome do modelo: canal, plano, limite, ferramenta disponível e regra de retenção continuam fazendo parte da decisão.
Ler análise

4 min de leitura

ConhecimentoProdutividadeEmpresasNegóciosLLMsAgentesAPIsEnterpriseSegurança

LançamentoMeta

Muse Wonder chega à API com agentes de longa duração, enquanto a versão Full fica na assinatura

Um arquivo alto alimenta dois fluxos de agentes: uma rota aberta por um portal de API e outra que entra numa oficina reservada, enquanto uma profissional supervisiona o conjunto.
Ilustração conceitual do acesso dividido. Muse Wonder entra na API e no ambiente de programação; Wonder Full permanece dentro dos planos superiores do Muse Code.

A Meta lançou Muse Wonder e Muse Wonder Full para programação, agentes de longa duração e uso de computador. Wonder está disponível na Meta Model API e no Muse Code, com contexto de um milhão de tokens e preço público por token. Full fica restrito aos planos Power e Maximum do Muse Code, sem API pública ou preço por token. Uma avaliação independente coloca os dois entre os modelos de maior pontuação, mas também aponta custo e verbosidade relevantes.

Por que importa. A novidade combina contexto longo, coordenação de subagentes e uso de computador em um produto disponível. Para equipes, a decisão não depende apenas do desempenho: canal de acesso, custo, revisão humana e possibilidade de trocar de fornecedor mudam entre as duas versões.

Ler análise

4 min de leitura

ProdutividadeConhecimentoEmpresasLLMsAgentesAutomaçãoAPIsEnterprise

LançamentoShengShu Technology

Vidu Q4 combina referências, câmera e áudio em vídeos curtos, ainda como preview

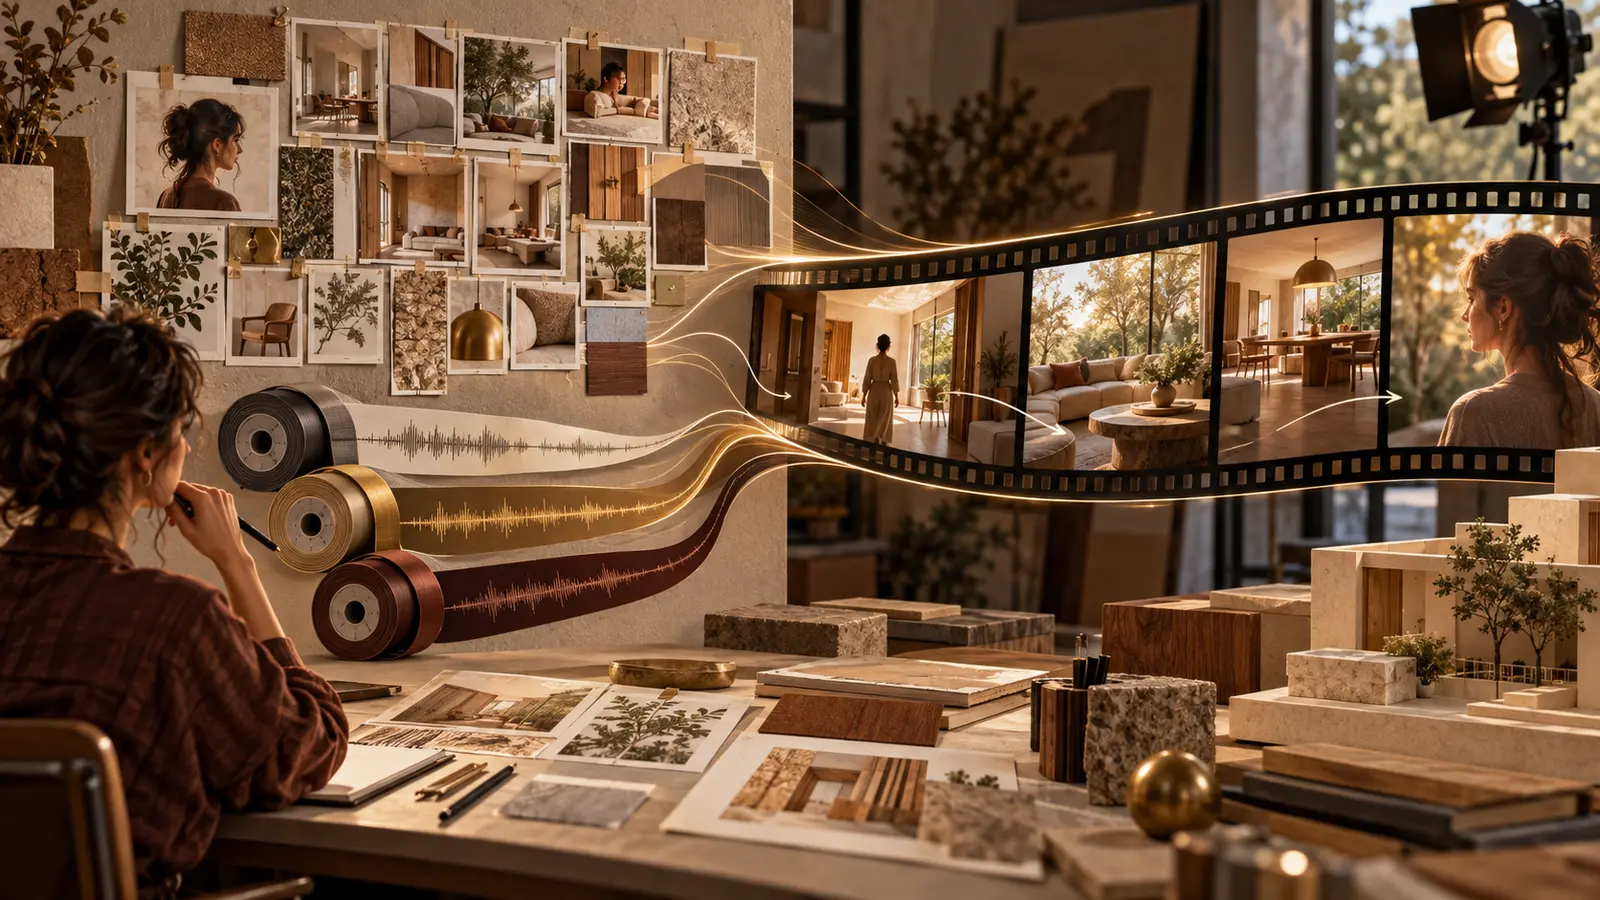
Referências de interiores, materiais e personagem se unem a três faixas de áudio e formam uma curta tira de filme, acompanhada por uma diretora diante de uma maquete arquitetônica.
Ilustração conceitual do fluxo por referências. Imagens e áudio orientam uma sequência curta com movimento de câmera; o resultado serve à narrativa visual, não ao modelo técnico do projeto.

O Vidu Q4 Preview está disponível no produto web e por API para transformar uma imagem inicial ou um conjunto de referências em clipes com áudio e troca automática de câmera. O modo por referência aceita até quinze imagens e três arquivos de áudio; a duração vai de três a dezesseis segundos e a resolução pode chegar a 4K. Em avaliação independente de image-to-video, o modelo ficou estatisticamente empatado com os líderes, mas o estágio continua preview e não há evidência de integração com CAD ou BIM.

Por que importa. A ferramenta aproxima continuidade visual, som e direção de câmera num único fluxo. Para equipes criativas, pode acelerar storyboards e apresentações, desde que duração, custo, direitos e consistência sejam testados antes de entrar numa entrega.

Ler análise

4 min de leitura

CriatividadeDesignArquiteturaProdutividadeVídeoÁudioImagemMultimodalidadeAPIs

IntegraçãoGraphisoft

Archicad 30 abre o BIM vivo à IA, mas mantém aprovação e desfazer

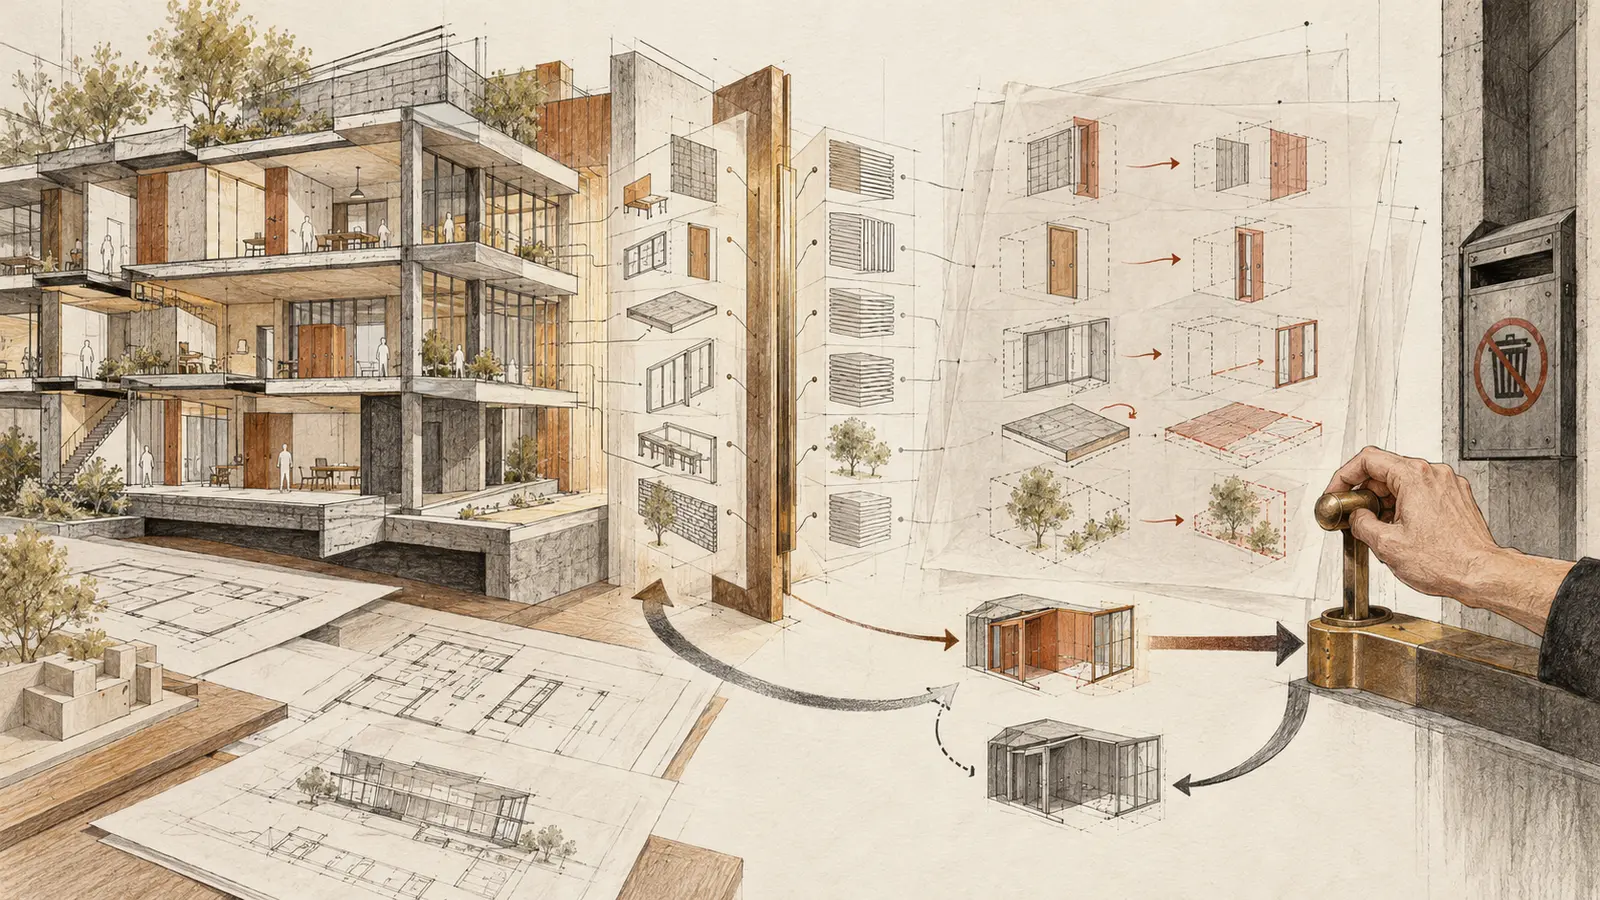
Modelo arquitetônico em corte envia elementos e propriedades por uma passagem estreita até folhas de alterações; uma mão controla a alavanca final e setas indicam o caminho de desfazer.
Ilustração conceitual do fluxo. O MCP abre o modelo para consulta e edições em lote, mas a proposta só volta ao BIM depois da aprovação humana e permanece reversível.

O Archicad 30 passou a oferecer acesso estruturado ao modelo BIM por MCP, tanto no AI Assistant interno quanto por um servidor público para clientes de desktop. A IA pode consultar elementos, extrair quantidades, analisar propriedades e preparar edições em lote. Cada alteração precisa de prévia e confirmação, entra como uma operação reversível e a exclusão de elementos não está disponível. O recurso é beta nos planos Collaborate e Max.

Por que importa. A conexão reduz exportação, planilha intermediária e repetição ao permitir que um assistente trabalhe sobre o estado atual do modelo. O ganho só é seguro se a equipe tratar cada proposta como alteração técnica: revisar escopo, conferir propriedades, preservar cópia e validar o resultado no BIM.

Ler análise

4 min de leitura

ArquiteturaDesignProdutividadeEmpresasAgentesAutomaçãoIntegraçãoAPIsEnterprise

LançamentoAnthropic

Haiku 5.5 barateia tarefas curtas, mas cobra cinco vezes mais depois de 100 mil tokens

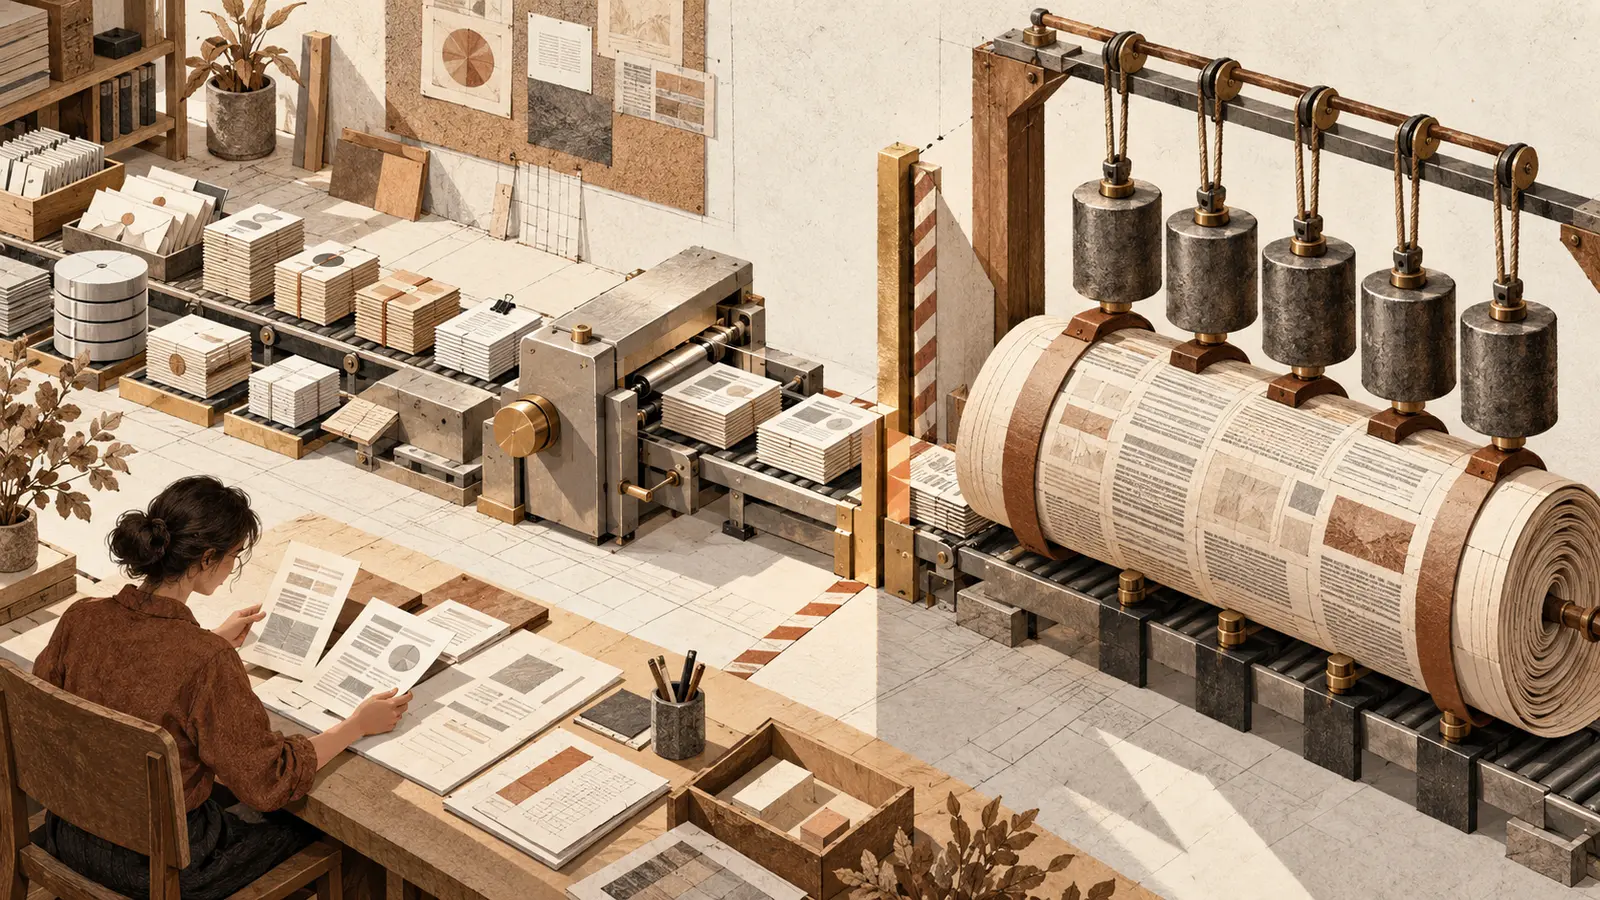
Pequenos lotes de documentos atravessam uma máquina compacta, enquanto um arquivo muito longo passa por um limite e recebe cinco contrapesos; uma analista confere as saídas.
Ilustração conceitual da nova curva de custo. Tarefas curtas passam por uma faixa econômica; contextos acima de 100 mil tokens exigem outra conta e avaliação humana da qualidade.

A Anthropic lançou o Claude Haiku 5.5 para classificação, resumo, extração, atendimento e subtarefas de agentes. Em prompts de até 100 mil tokens, custa US$ 0,10 por milhão de tokens de entrada e US$ 0,50 por milhão de saída. Acima desse limite, os valores sobem para US$ 0,50 e US$ 2,50. O modelo está disponível, mas a economia depende de medir o contexto total de cada tarefa.

Por que importa. O lançamento torna viável distribuir tarefas estreitas e repetitivas entre modelos menores, inclusive como subagentes de fluxos mais complexos. A mudança também cria uma armadilha simples: uma tarefa aparentemente barata pode multiplicar o preço quando histórico, anexos e instruções ultrapassam 100 mil tokens.

Ler análise

4 min de leitura

ProdutividadeConhecimentoEmpresasLLMsMultimodalidadeAgentesAPIsEnterprise

LançamentoMistral AI

Mistral Large 4 chega à API antes de liberar seus pesos

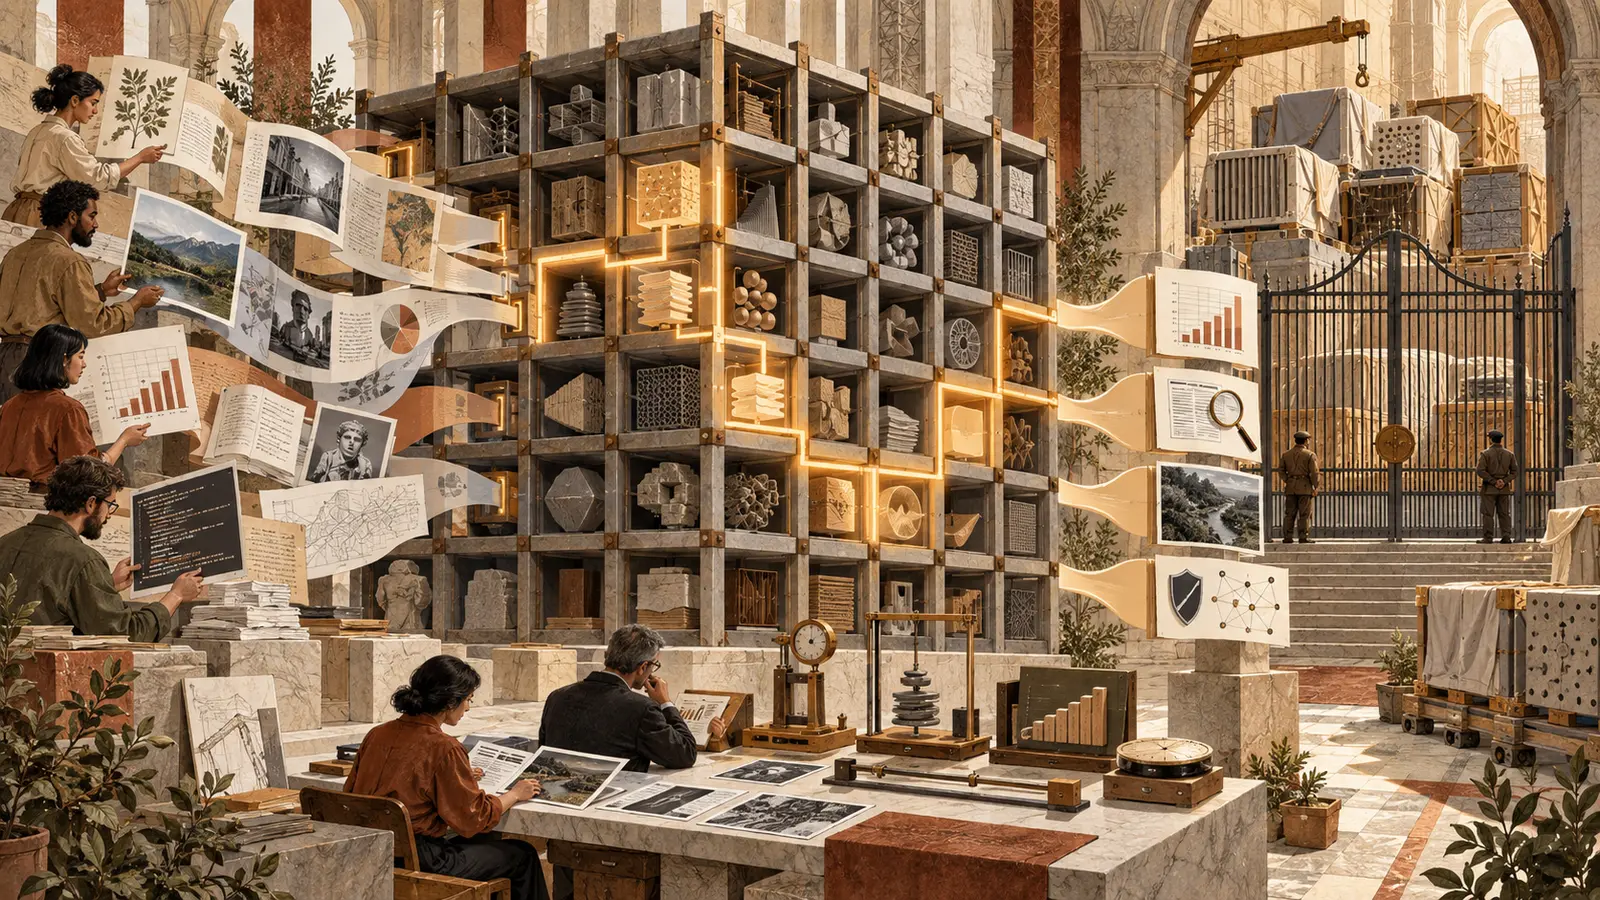
Documentos, imagens, gráficos e código atravessam uma grande matriz modular por poucos caminhos ativos; avaliadores medem resultados enquanto módulos fechados aguardam atrás de um portão.
Ilustração conceitual do estágio atual. O preview de API aceita múltiplos formatos e ativa parte da arquitetura por tarefa, enquanto pesos e artefatos prometidos continuam aguardando liberação.

A Mistral colocou o Large 4 em preview público na API em 6 de outubro. O modelo esparso combina 1,05 trilhão de parâmetros totais, 52 bilhões ativos e codificador visual de 1,6 bilhão, segundo a documentação. A Artificial Analysis encontrou desempenho forte em segurança cibernética, mas índice geral abaixo de líderes fechados e custo maior por tarefa. Os pesos ainda não estão disponíveis.

Por que importa. O Large 4 combina contexto longo, visão, uso de ferramentas e especialização em um modelo europeu que já pode ser testado por API. A diferença entre preview utilizável e pesos ainda fechados é decisiva para quem avalia soberania, execução própria, adaptação e auditoria.

Ler análise

4 min de leitura

ProdutividadeConhecimentoEmpresasLLMsMultimodalidadeAgentesAPIsEnterpriseSegurança

LançamentoReflection AI

Beam promete um modelo aberto eficiente, mas os pesos ainda não chegaram

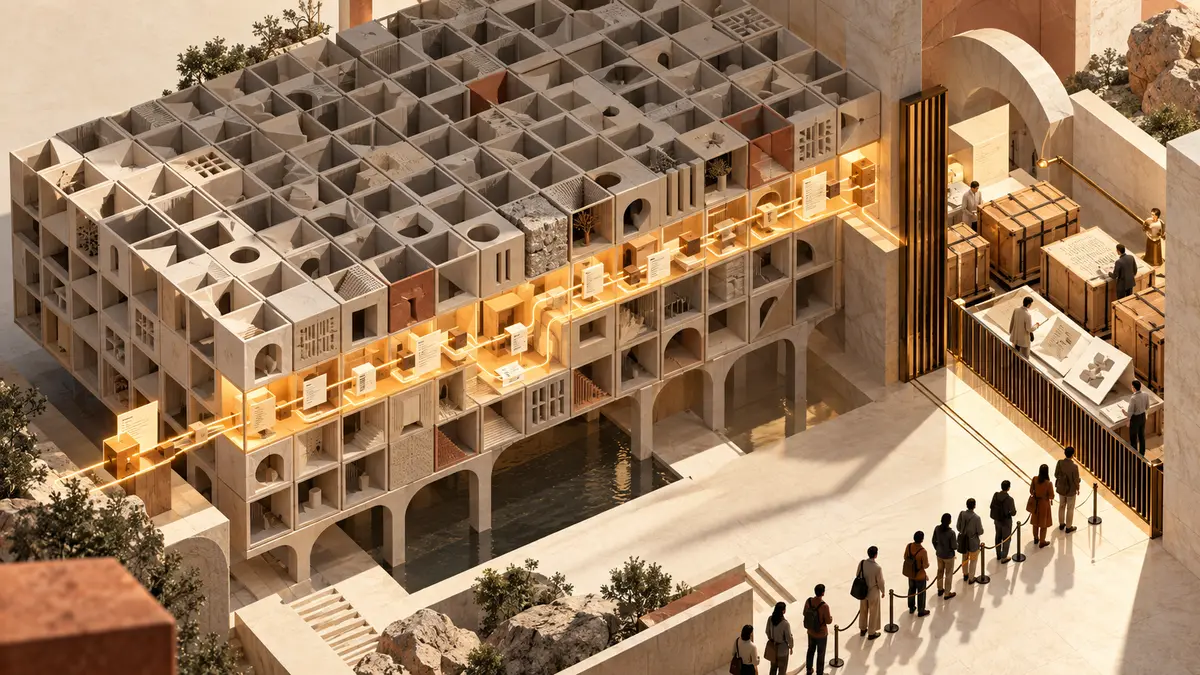
Uma grande matriz arquitetônica mantém apenas um corredor iluminado em atividade, enquanto caixas de pesos, relatório técnico e ficha do modelo aguardam inspeção atrás de um portão.
Ilustração conceitual do estágio atual. Uma parte pequena da estrutura é ativada por tarefa, mas pesos e documentação continuam atrás do portão de testes finais.

A Reflection AI apresentou o Beam, modelo de texto com arquitetura esparsa voltado a código, raciocínio e agentes. A empresa informa 501 bilhões de parâmetros totais e 23 bilhões ativos por token, mas o modelo ainda está em desenvolvimento: só há lista de acesso antecipado e os pesos não podem ser baixados. Benchmarks e alegações de eficiência são do fornecedor e não tiveram reprodução independente.

Por que importa. Modelos com pesos disponíveis podem ser executados e adaptados em infraestrutura própria, o que muda custo, controle e auditoria. Beam ainda não oferece essa possibilidade. Por enquanto, a notícia é uma promessa técnica acompanhada de acesso restrito, não uma alternativa pronta para implantação.

Ler análise

4 min de leitura

ConhecimentoProdutividadeEmpresasLLMsAgentesAPIsEnterprise

LançamentoMicrosoft AI

Microsoft leva voz em tempo real ao preview com português documentado

Em um estúdio de arquitetura, a fala de uma profissional se transforma em ondas, fragmentos de transcrição e cartões de ação antes de retornar como voz por uma pequena caixa de som.
Ilustração conceitual do ciclo de voz em tempo real. Hipóteses parciais chegam antes do fim da fala, mas precisam estabilizar antes de virar registro ou ação.

A Microsoft lançou em preview público o MAI-Transcribe-2-Streaming, seu primeiro modelo da família MAI para transcrição contínua. Ele recebe áudio em fluxo, revisa hipóteses parciais e confirma segmentos finais em 60 idiomas. Com MAI-Voice-2.1 e Flash, completa um pipeline de agentes de voz, legendas e ditado; português aparece na documentação, mas o preview não é recomendado para produção.

Por que importa. Interfaces de voz podem começar a legendar, registrar ou preparar uma ação antes do fim da frase. Para atendimento, reuniões, aulas e acessibilidade, a promessa é reduzir espera; o teste profissional precisa medir erro e latência com português brasileiro, ruído e vocabulário real antes de qualquer uso crítico.

Ler análise

3 min de leitura

ProdutividadeConhecimentoEmpresasNegóciosÁudioMultimodalidadeAgentesAPIs

LançamentoCloudflare

Clef troca texto livre por decisões tipadas dentro de agentes

Uma máquina tátil de latão recebe texto, imagem e amostra de material, pondera evidências e distribui fichas entre gavetas de decisão; um caso ambíguo segue para revisão humana.
Ilustração conceitual de decisões tipadas. A saída estruturada simplifica o roteamento, mas casos ambíguos continuam precisando de limiar, fallback e revisão.

A Cloudflare lançou Clef e Clef-flash, modelos multimodais especializados em decisões fechadas. Em vez de redigir uma resposta, recebem um estado e perguntas tipadas e devolvem probabilidades para sim ou não, escolha ou score. Os modelos estão disponíveis no Workers AI e com pesos abertos; o serviço de ajuste por reforço ainda opera com parceiros de design.

Por que importa. Triagem, roteamento, classificação visual e checagens de política nem sempre precisam de um parágrafo. Uma saída tipada pode reduzir parsing, custo e latência, mas também automatizar um erro em escala; a probabilidade precisa ser calibrada no domínio real e ligada a revisão nos casos de maior impacto.

Ler análise

3 min de leitura

ProdutividadeEmpresasNegóciosConhecimentoAgentesAutomaçãoAPIsMultimodalidade

LançamentoAWV Informatik

ClassCAD leva agentes a um kernel paramétrico com verificação geométrica

Um programa paramétrico alimenta um flange tridimensional cercado por planos de corte, cotas e marcadores; duas pessoas conferem desenhos e a peça com paquímetro.
Ilustração conceitual do ClassCAD.ai. O agente escreve e executa geometria paramétrica; medidas e vistas ajudam a verificar o sólido antes da revisão humana.

O ClassCAD.ai conectou agentes como Claude, Codex, Cursor e VS Code a um kernel CAD programável. O agente escreve um programa, gera geometria, calcula propriedades, produz vistas determinísticas e exporta STEP, STL ou outros formatos. A verificação comprova propriedades do sólido, não a correção do projeto ou sua fabricabilidade.

Por que importa. O diferencial não é uma imagem de conceito, mas um objeto CAD programável, mensurável e exportável. Isso abre automação para peças, configuradores e protótipos, mas exige distinguir prova geométrica de intenção correta, tolerância, norma e fabricação.

Ler análise

3 min de leitura

DesignArquiteturaProdutividadeEmpresasAgentesAutomaçãoIntegraçãoAPIs

LançamentoOpenAI

GPT-6.1 Sol aproxima desempenho de topo com custo menor, mas acesso segue fragmentado

Três profissionais trabalham com código, documentos e fluxos conectados ao mesmo núcleo computacional; uma balança compara capacidade e custo, enquanto uma porta comum permanece fechada.
Ilustração conceitual da proposta do GPT-6.1 Sol. O mesmo contexto alimenta tarefas profissionais distintas, mas o acesso continua separado entre Work, Codex e API.

A OpenAI lançou o GPT-6.1 Sol em 29 de setembro para trabalho profissional, programação agêntica, uso de computador e pesquisa. A empresa o posiciona perto do GPT-6 Astra por uma fração do preço. O Vals Index confirma uma relação custo-desempenho melhor nesse conjunto, sem provar superioridade geral nem segurança automática.

Por que importa. A mudança prática não é apenas uma nova pontuação, mas o custo por tarefa longa e revisável. Um modelo intermediário mais capaz pode ampliar testes de agentes e documentos, desde que a equipe meça resultado final, supervisão, risco e disponibilidade no produto que realmente usa.

Ler análise

4 min de leitura

ConhecimentoProdutividadeEmpresasNegóciosLLMsAgentesAutomaçãoEnterpriseAPIsSegurança

LançamentoGoogle

Gemini 4 Argon estreia em preview fechado para ciberdefensores

Um núcleo computacional fica protegido dentro de uma câmara de acesso controlado, onde três especialistas examinam documentos; um grande salão público permanece vazio do lado de fora.
Ilustração conceitual do acesso restrito ao Gemini 4 Argon. O modelo foi apresentado, mas o uso inicial permanece limitado a ciberdefensores e testers selecionados.

O Google apresentou o Gemini 4 Argon em 30 de setembro. A primeira coorte reúne ciberdefensores e testers selecionados no programa Fairwind; API paga e Google AI Ultra aparecem como próximos passos, sem cronograma. O modelo liderou a edição consultada do Vals Index, mas parte importante da evidência de desempenho continua sendo autorreportada pelo fornecedor.

Por que importa. Argon sinaliza a próxima geração do Gemini para engenharia, trabalho profissional e defesa cibernética. Para decisões de compra, porém, anúncio e benchmark não equivalem a disponibilidade: hoje não há endpoint público, prazo geral ou teste amplo em fluxos reais de equipes brasileiras.

Ler análise

4 min de leitura

ConhecimentoProdutividadeEmpresasNegóciosLLMsSegurançaEnterpriseAPIs