Pesquisa · Austrian Academy of Sciences
Apollo propõe lacunas em textos gregos antigos, sem retirar a decisão dos especialistas
O modelo especializado está aberto para uso; os resultados promissores vêm de um preprint dos próprios desenvolvedores.
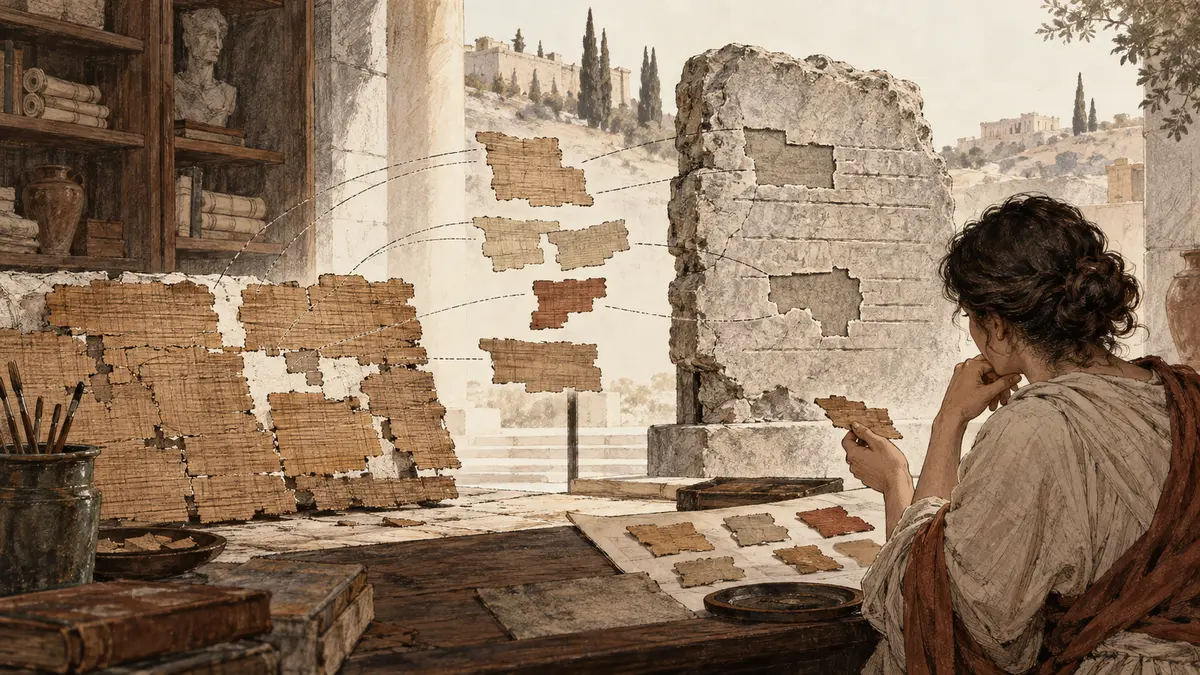
A Academia Austríaca de Ciências, a Mistral AI, a SAIL Reply e a Northeastern University apresentaram o Apollo Restore, modelo de 24 bilhões de parâmetros treinado para sugerir preenchimentos de lacunas em papiros, inscrições e manuscritos em grego histórico. A aplicação é gratuita e aberta, mas cada proposta ainda exige validação filológica e histórica.
- Acontecimento
- Publicação
- Última revisão
- Leitura
- 3 min
O que aconteceu
Em 23 de setembro, a Academia Austríaca de Ciências apresentou a primeira fase do Apollo, sistema desenvolvido com Mistral AI, SAIL Reply e Northeastern University. A aplicação está disponível gratuitamente para pesquisadores e público geral.
O componente Apollo Restore é um modelo de 24 bilhões de parâmetros ajustado a partir do Mistral Small. Ele foi treinado com cerca de 600 milhões de palavras em grego histórico para completar trechos ausentes no meio de papiros, inscrições e manuscritos.
O que mudou
A pessoa insere o trecho fragmentário e o sistema produz candidatos que podem ser comparados. O objetivo é adaptar vocabulário e registro a diferentes períodos e gêneros, oferecendo hipóteses para passagens que antes exigiam busca manual extensa em paralelos textuais.
A própria equipe enquadra a ferramenta como apoio. Datação, autoria, contexto material, coerência histórica e escolha final permanecem fora do alcance de uma simples previsão de palavras.
Por que importa
Patrimônio cultural é um exemplo claro de trabalho em que a resposta precisa conviver com incerteza, proveniência e revisão especializada. Uma sugestão plausível pode abrir uma pista, mas não se torna evidência apenas porque foi produzida por um modelo.
Para outras áreas, Apollo reforça o valor de modelos ajustados a corpus e tarefa bem definidos. O desenho pode inspirar pesquisa jurídica, arquivos institucionais e documentação técnica, desde que o sistema mostre alternativas e preserve o vínculo com as fontes.
Para quem importa
Papirologistas, epigrafistas, linguistas, historiadores, bibliotecas, museus e arquivos com coleções fragmentárias. Também interessa a equipes que constroem ferramentas de pesquisa para domínios com poucos dados e alto custo de erro.
Não é uma solução geral de OCR nem um leitor automático de manuscritos inéditos. A fase apresentada trabalha principalmente com restauração textual; decifração de imagens e busca semântica mais ampla aparecem como etapas futuras.
Impacto prático
O uso responsável começa registrando a transcrição de entrada, as lacunas, os candidatos retornados, a posição de cada sugestão e o motivo da escolha humana. Isso transforma a IA em parte auditável do argumento, não em uma autoridade invisível.
Em acervos ainda não publicados, também é necessário conferir direitos, política institucional, localização do processamento e risco de expor material sensível antes de usar uma aplicação externa.
O que testar
Use passagens já restauradas, esconda trechos de tamanhos variados e compare a posição da leitura aceita entre os candidatos. Separe papiros documentais, literatura e inscrições, porque o desempenho divulgado varia entre esses conjuntos.
Peça a dois especialistas que avaliem sugestões sem saber sua origem e registrem concordância, justificativa e confiança. O teste deve medir utilidade para o processo, não apenas se uma sequência conhecida aparece entre vinte opções.
O que observar
Os autores relatam que a leitura correta apareceu entre as vinte melhores sugestões em 80,6% dos papiros documentais, 54,6% dos literários e 61% das inscrições. Em um estudo cego com vinte especialistas, 77% das propostas foram avaliadas como pelo menos tão boas quanto restaurações humanas.
Esses resultados pertencem ao preprint dos desenvolvedores. A cobertura da Wired confirma lançamento, parceiros, corpus e acesso, mas não reproduz os experimentos. Também vale acompanhar a promessa de acrescentar decifração, busca temática e paralelos citáveis.
O que ainda não sabemos
O trabalho ainda não passou por revisão por pares nem por replicação independente ampla. O estudo usa conjuntos, critérios e participantes definidos pela própria equipe, e não demonstra precisão uniforme para todo o grego histórico.
Também não está claro como o sistema se comporta diante de transcrições muito incertas, tradições textuais raras, inscrições multilíngues ou hipóteses em que contexto arqueológico pesa mais do que probabilidade linguística.
Fontes
- AI Speaks Ancient Greek: Apollo Restores 2,000-Year-Old TextsAustrian Academy of Sciences · Fonte oficial · publicada em 23 de setembro de 2026 · conferida em 28 de setembro de 2026
- Apollo Restore: A Foundation LLM for Historical Greek Optimized for Fill-in-the-Middle Restoration of Ancient Greek TextsApollo Restore research team · Paper · publicada em 18 de setembro de 2026 · conferida em 28 de setembro de 2026
- A New Chatbot Wants to Unlock the Secrets in Tattered Ancient Greek RecordsWIRED · Imprensa geral · publicada em 23 de setembro de 2026 · conferida em 28 de setembro de 2026